经验累积分布曲线
GAL-0031
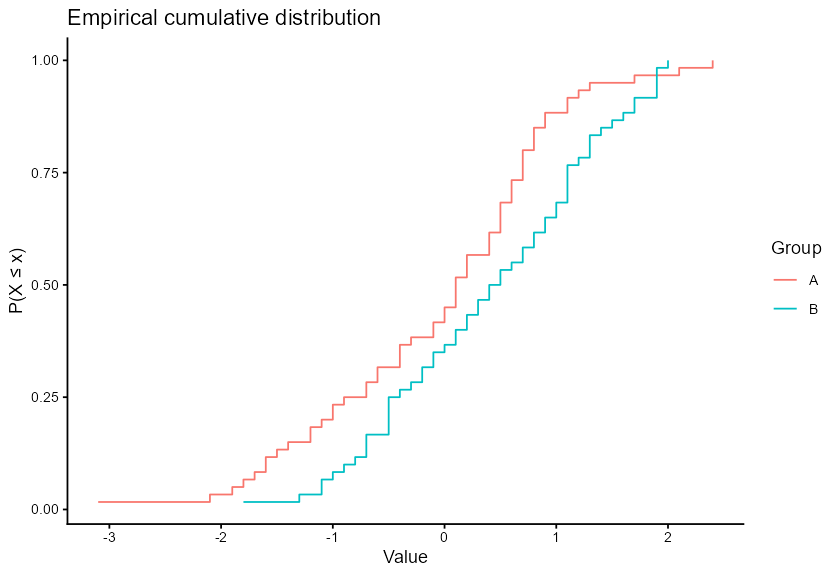
用经验累积分布比较不同组的分布、尾部与分位数。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))
dir.create("outputs", showWarnings=FALSE)
d <- read.csv("data/input.csv", check.names=FALSE)
d<-d[is.finite(d$value),];stopifnot(nrow(d)>0)
tab<-aggregate(list(n=d$value),list(group=d$group,value=d$value),length);tab<-tab[order(tab$group,tab$value),];tab$fraction<-ave(tab$n,tab$group,FUN=function(x)cumsum(x)/sum(x))
stats<-data.frame(key=paste0("n_",names(table(d$group))),value=as.numeric(table(d$group)))
stats<-rbind(stats,data.frame(key=paste0("ecdf_",tab$group,"_",ave(seq_len(nrow(tab)),tab$group,FUN=seq_along)),value=tab$fraction))
p<-ggplot(tab,aes(value,fraction,colour=group))+geom_step(direction="hv")+theme_classic()+labs(x="Value",y="P(X ≤ x)",colour="Group",title="Empirical cumulative distribution")

stats <- stats[order(stats$key), ]
write.csv(stats, "outputs/stats_r.csv", row.names=FALSE)
nums <- lapply(seq_len(nrow(stats)), function(i) list(id=stats$key[i], value=stats$value[i], display=sprintf("%.6f", stats$value[i]), source=list(type="computed",locator="code/R/main.R")))
jsonlite::write_json(list(schema="zzy-media-studio/numbers/v1",asset=basename(normalizePath(".")),numbers=nums),"outputs/numbers.json",auto_unbox=TRUE,pretty=TRUE,digits=16)
ggsave("outputs/figure_r.png", p, width=7,height=4.8,dpi=120,bg="white")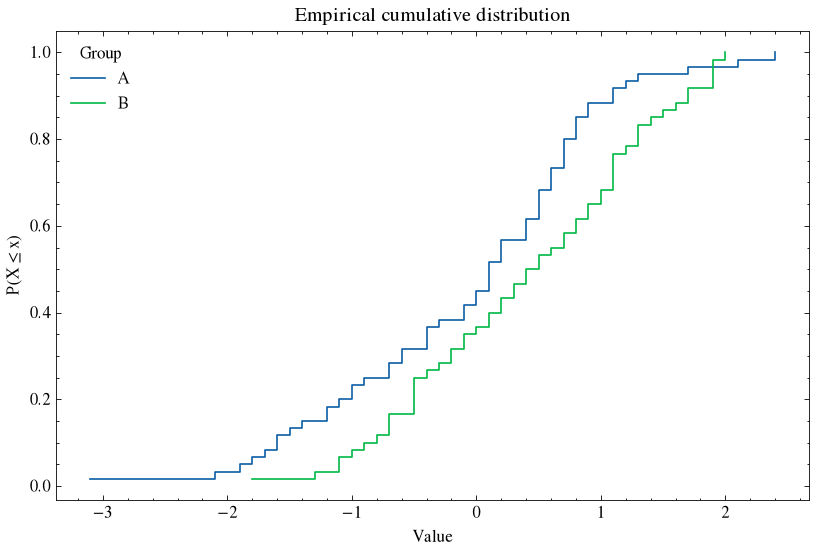
code/py/main.py
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots
plt.style.use(["science", "no-latex"])
Path("outputs").mkdir(exist_ok=True)
d=pd.read_csv("data/input.csv")
fig,ax=plt.subplots(figsize=(7,4.8))
d=d[np.isfinite(d.value)];assert len(d)>0
for group,s in d.groupby("group",sort=True):
 vals=np.sort(s.value.to_numpy());unique,counts=np.unique(vals,return_counts=True);ax.step(unique,np.cumsum(counts)/len(vals),where="post",label=group)
stats=[(f"n_{g}",len(s)) for g,s in d.groupby("group",sort=True)]
for group,s in d.groupby("group",sort=True):
 unique,counts=np.unique(s.value,return_counts=True)
 stats.extend((f"ecdf_{group}_{i}",v) for i,v in enumerate(np.cumsum(counts)/len(s),1))
ax.legend(title="Group");ax.set(xlabel="Value",ylabel="P(X ≤ x)",title="Empirical cumulative distribution")

pd.DataFrame(stats,columns=["key","value"]).sort_values("key").to_csv("outputs/stats_py.csv",index=False)
fig.tight_layout()
fig.savefig("outputs/figure_py.png",dpi=120,facecolor="white")
plt.close(fig)
什么时候用
- 比较不同组的整体分布、分位数位置及尾部差异
常见误用
- 曲线为P(X≤x),并列值在同一点一起跳跃
- 缺失值需先排除并按有效观测数计算分母
数据与下载
数据:固定随机种子的原创模拟数据(原创模拟数据 CC0-1.0)。共享CSV,模拟教学数据,不含真实患者或真实测序样本
下载包 sha256:bf7040020b53173f6609d3c991104dad11244dd2043f07d2d5b343836ba2c576