样本相关性与批次注释热图
GAL-0029
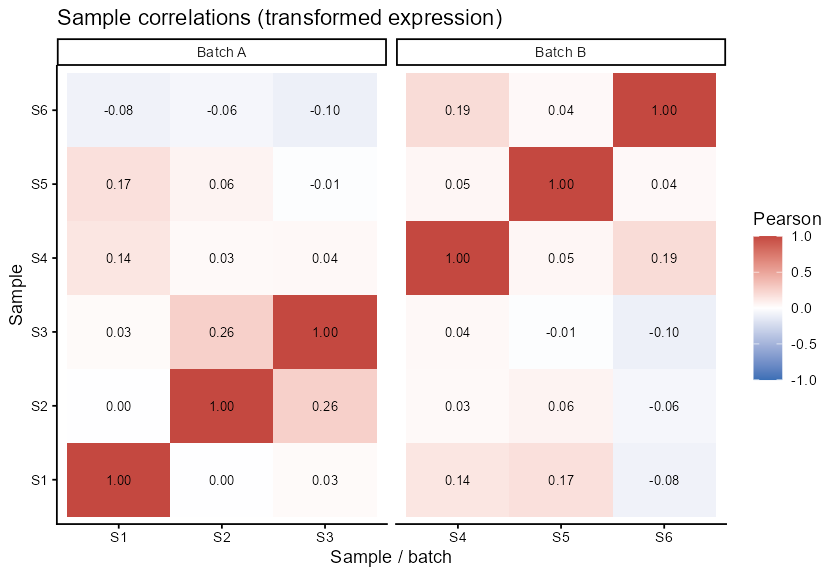
对已转换的基因×样本表达矩阵计算样本间Pearson相关。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))
dir.create("outputs", showWarnings=FALSE)
d <- read.csv("data/input.csv", check.names=FALSE)
m <- as.matrix(d[,-1]);stopifnot(all(apply(m,2,sd)>0))
corr <- cor(m,method="pearson"); tab <- as.data.frame(as.table(corr));names(tab)<-c("sample_x","sample_y","value")
tab$batch <- ifelse(tab$sample_x %in% c("S1","S2","S3"),"Batch A","Batch B")
stats <- data.frame(key=paste(tab$sample_x,tab$sample_y,sep="_"),value=tab$value)
p <- ggplot(tab,aes(sample_x,sample_y,fill=value))+geom_tile()+geom_text(aes(label=sprintf("%.2f",ifelse(abs(value)<.005,0,value))),size=2.8)+facet_grid(.~batch,scales="free_x",space="free_x")+scale_fill_gradient2(low="#3b6fb6",mid="white",high="#c44840",midpoint=0,limits=c(-1,1))+theme_classic()+labs(x="Sample / batch",y="Sample",fill="Pearson",title="Sample correlations (transformed expression)")

stats <- stats[order(stats$key), ]
write.csv(stats, "outputs/stats_r.csv", row.names=FALSE)
nums <- lapply(seq_len(nrow(stats)), function(i) list(id=stats$key[i], value=stats$value[i], display=sprintf("%.6f", stats$value[i]), source=list(type="computed",locator="code/R/main.R")))
jsonlite::write_json(list(schema="zzy-media-studio/numbers/v1",asset=basename(normalizePath(".")),numbers=nums),"outputs/numbers.json",auto_unbox=TRUE,pretty=TRUE,digits=16)
ggsave("outputs/figure_r.png", p, width=7,height=4.8,dpi=120,bg="white")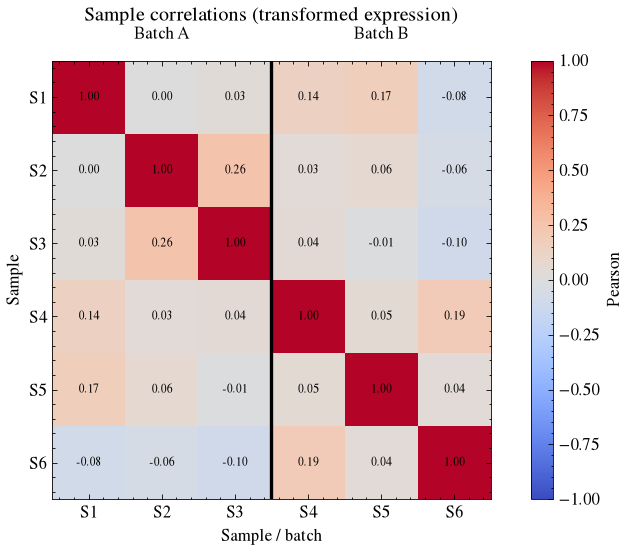
code/py/main.py
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots
plt.style.use(["science", "no-latex"])
Path("outputs").mkdir(exist_ok=True)
d=pd.read_csv("data/input.csv")
fig,ax=plt.subplots(figsize=(7,4.8))
m=d.drop(columns="gene");assert (m.std()>0).all();corr=m.corr(method="pearson")
img=ax.imshow(corr,vmin=-1,vmax=1,cmap="coolwarm");fig.colorbar(img,ax=ax,label="Pearson")
ax.set_xticks(range(len(m.columns)),m.columns);ax.set_yticks(range(len(m.columns)),m.columns)
for i in range(len(m.columns)):
 for j in range(len(m.columns)):
  v=corr.iloc[i,j];ax.text(j,i,f"{0 if abs(v)<.005 else v:.2f}",ha="center",va="center",fontsize=7)
ax.axvline(2.5,color="black",linewidth=2);ax.text(1,-.8,"Batch A",ha="center");ax.text(4,-.8,"Batch B",ha="center")
stats=[(f"{x}_{y}",corr.loc[y,x]) for x in m.columns for y in m.columns]
ax.set(xlabel="Sample / batch",ylabel="Sample")
ax.set_title("Sample correlations (transformed expression)",pad=24)

pd.DataFrame(stats,columns=["key","value"]).sort_values("key").to_csv("outputs/stats_py.csv",index=False)
fig.tight_layout()
fig.savefig("outputs/figure_py.png",dpi=120,facecolor="white")
plt.close(fig)
什么时候用
- 检查样本表达相似性并对照已知批次信息
常见误用
- 样本为相关矩阵对象,基因是观测维度
- 相关性和批次聚集是探索性诊断,不证明批次效应
数据与下载
数据:固定随机种子的原创模拟数据(原创模拟数据 CC0-1.0)。共享CSV直接模拟变换后的表达量,并非从真实或模拟原始计数转换;无真实测序样本
下载包 sha256:092ac9eef913127a287d4ebeaafe4aa248bb1a066f821fb32c7a56f59e619b75