RNA-seq文库大小与零计数比例
GAL-0028
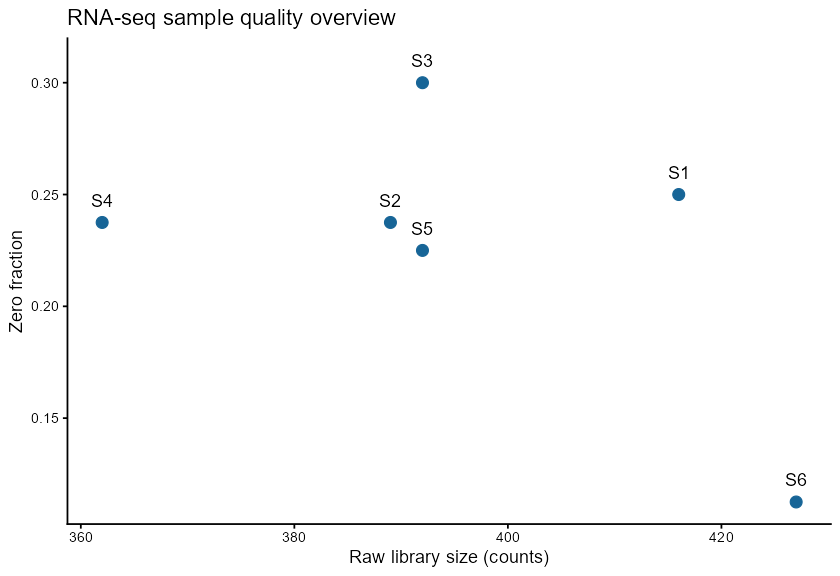
从原始整数计数计算样本总计数与零计数比例。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))
dir.create("outputs", showWarnings=FALSE)
d <- read.csv("data/input.csv", check.names=FALSE)
m <- as.matrix(d[,-1]); stopifnot(all(m>=0),all(m==floor(m)))
tab <- data.frame(sample=colnames(m),library_size=colSums(m),zero_fraction=colMeans(m==0))
stats <- data.frame(key=c(paste0("library_",tab$sample),paste0("zero_",tab$sample)),value=c(tab$library_size,tab$zero_fraction))
p <- ggplot(tab,aes(library_size,zero_fraction,label=sample))+geom_point(size=3,colour="#176597")+geom_text(nudge_y=.01)+theme_classic()+labs(x="Raw library size (counts)",y="Zero fraction",title="RNA-seq sample quality overview")

stats <- stats[order(stats$key), ]
write.csv(stats, "outputs/stats_r.csv", row.names=FALSE)
nums <- lapply(seq_len(nrow(stats)), function(i) list(id=stats$key[i], value=stats$value[i], display=sprintf("%.6f", stats$value[i]), source=list(type="computed",locator="code/R/main.R")))
jsonlite::write_json(list(schema="zzy-media-studio/numbers/v1",asset=basename(normalizePath(".")),numbers=nums),"outputs/numbers.json",auto_unbox=TRUE,pretty=TRUE,digits=16)
ggsave("outputs/figure_r.png", p, width=7,height=4.8,dpi=120,bg="white")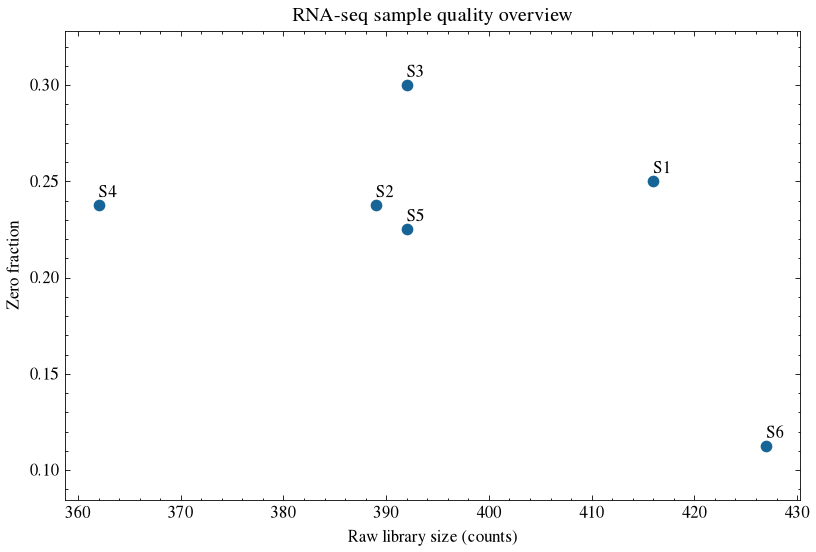
code/py/main.py
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots
plt.style.use(["science", "no-latex"])
Path("outputs").mkdir(exist_ok=True)
d=pd.read_csv("data/input.csv")
fig,ax=plt.subplots(figsize=(7,4.8))
m=d.drop(columns="gene");assert (m>=0).all().all() and (m==np.floor(m)).all().all()
s=m.sum();z=(m==0).mean();ax.scatter(s,z,color="#176597")
for name in m.columns: ax.annotate(name,(s[name],z[name]),xytext=(0,5),textcoords="offset points")
ax.margins(y=.15)
stats=[*( ("library_"+n,s[n]) for n in m.columns),*(("zero_"+n,z[n]) for n in m.columns)]
ax.set(xlabel="Raw library size (counts)",ylabel="Zero fraction",title="RNA-seq sample quality overview")

pd.DataFrame(stats,columns=["key","value"]).sort_values("key").to_csv("outputs/stats_py.csv",index=False)
fig.tight_layout()
fig.savefig("outputs/figure_py.png",dpi=120,facecolor="white")
plt.close(fig)
什么时候用
- RNA-seq原始计数样本的测序深度与稀疏程度初步检查
常见误用
- 文库大小是原始计数之和,不是DESeq2归一化因子
- 零比例受测序深度与数据类型影响,不能单独判断质量
数据与下载
数据:固定随机种子的原创模拟数据(原创模拟数据 CC0-1.0)。共享CSV,模拟教学数据,不含真实患者或真实测序样本
下载包 sha256:6bf3d568e936cfbd7d37391cff84054c80361886890829086ff8e46179a1be72