蜂群图 / sina 图(显示每个点的分布)
GAL-0021
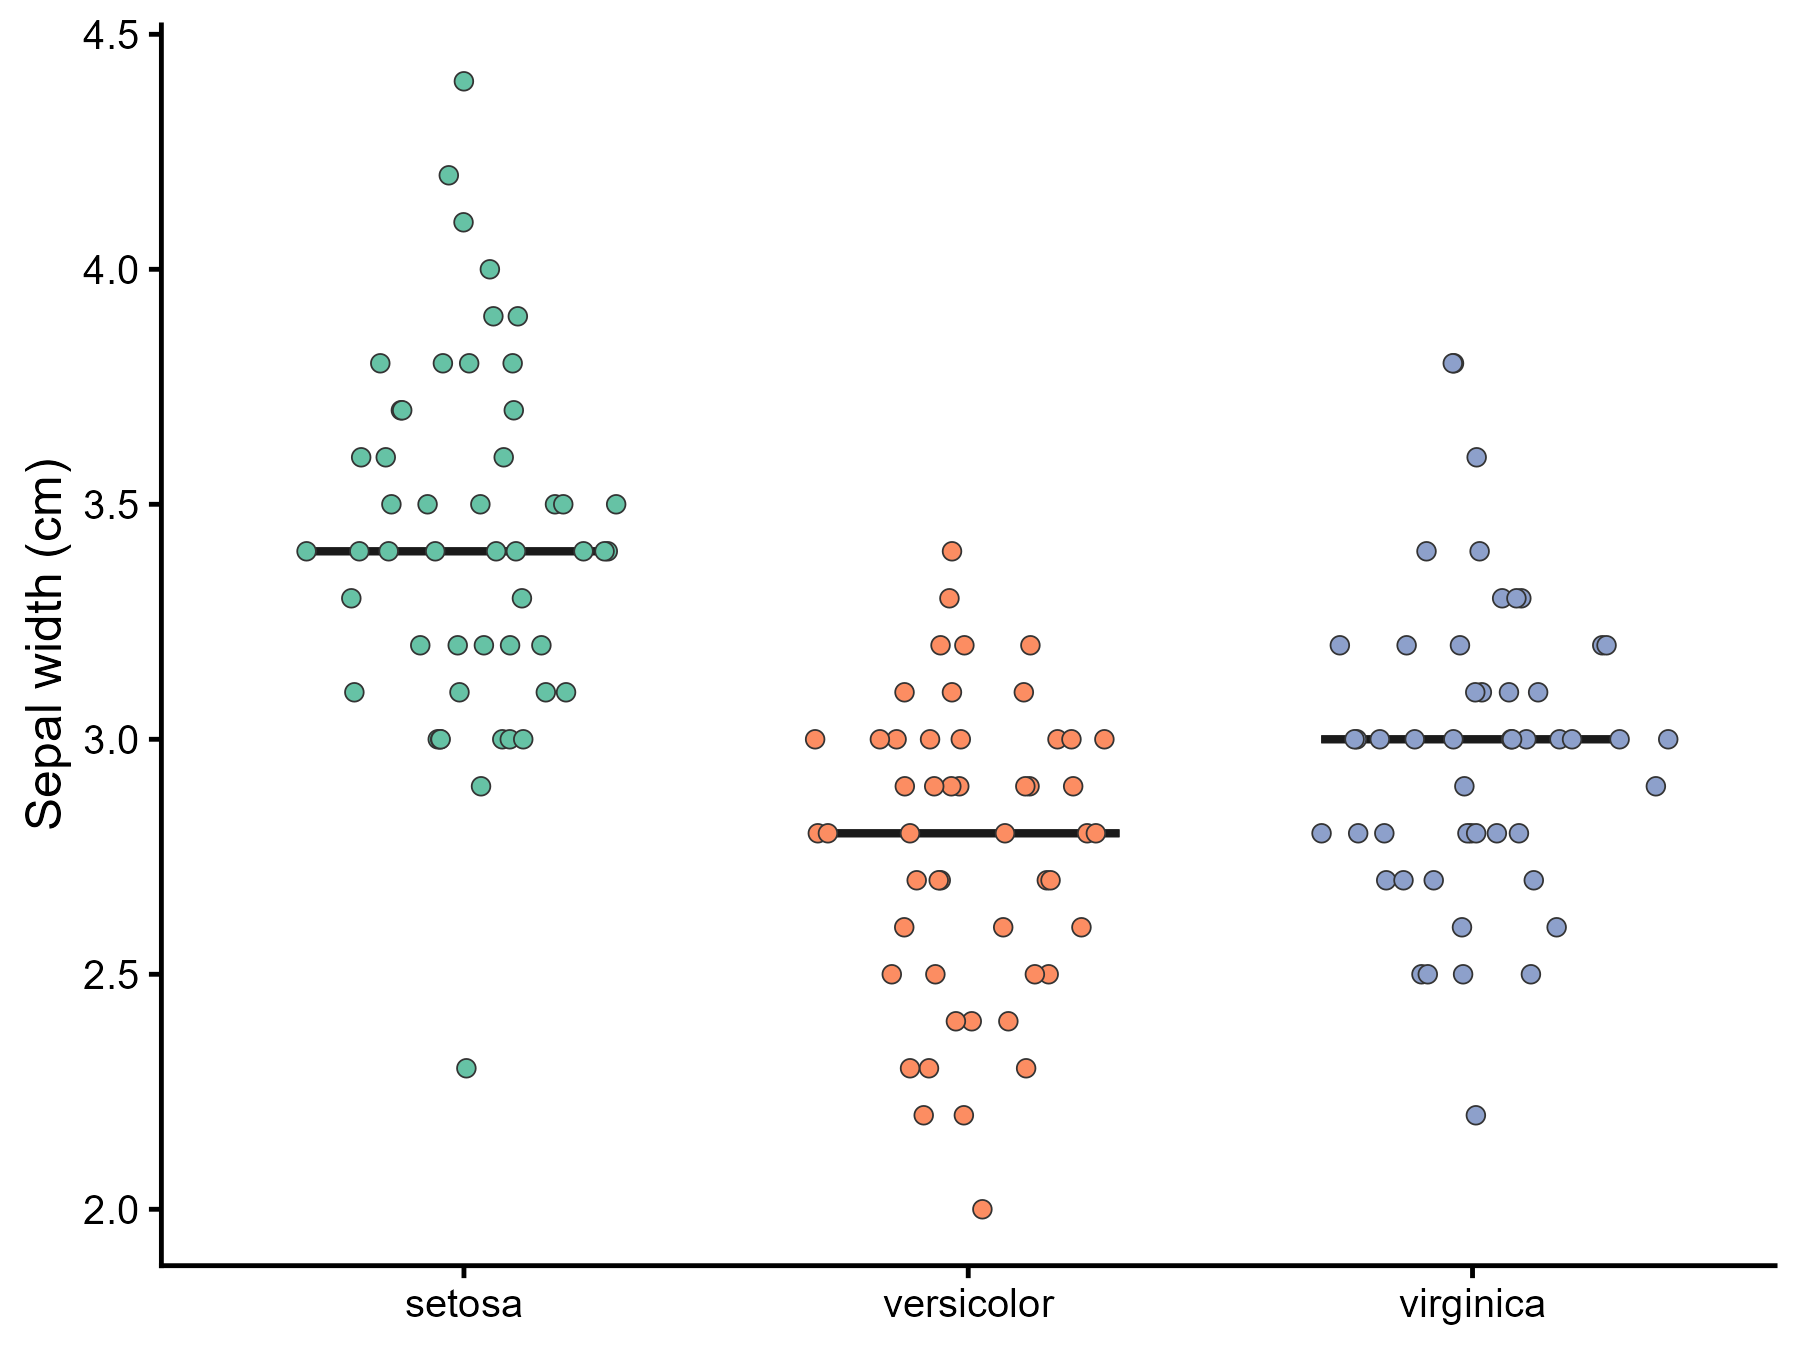
把每个观测值都画成一个点,并在横向错开以减少重叠,既显示每个点,又能看出分布的疏密和形状。R 版是 sina 图(点的横向宽度随密度变化),Python 版是蜂群图(swarm,点互不重叠地向两侧排开)。sina 的横向位置带随机成分,取值相同的点仍可能部分重叠(如本例 virginica 的两个 3.8)。中位数线画在点的下层。
图与代码
code/R/main.R
suppressPackageStartupMessages({
  library(ggplot2)
  library(ggforce)
})

d <- read.csv("data/iris_sepal_width.csv", encoding = "UTF-8")
sp <- c("setosa", "versicolor", "virginica")
d$Species <- factor(d$Species, levels = sp)

st <- data.frame(item = c(paste0(sp, "_n"), paste0(sp, "_median"), paste0(sp, "_mean")),
                 value = c(as.character(as.vector(table(d$Species))),
                           sprintf("%.4f", tapply(d$Sepal.Width, d$Species, median)),
                           sprintf("%.4f", tapply(d$Sepal.Width, d$Species, mean))))
write.csv(st, "outputs/stats_r.csv", row.names = FALSE, quote = FALSE)
med <- aggregate(Sepal.Width ~ Species, d, median)

# sina 图:y 方向按密度确定点的横向展开宽度,宽度内随机错开(固定种子)
p <- ggplot(d, aes(x = Species, y = Sepal.Width, fill = Species)) +
  # 中位数线先画、点后画:取值等于中位数的点不被线压住
  geom_errorbar(data = med, aes(ymin = Sepal.Width, ymax = Sepal.Width), width = 0.6, linewidth = 0.9, colour = "grey10") +
  geom_sina(shape = 21, size = 1.9, colour = "grey20", stroke = 0.3, maxwidth = 0.8, seed = 1) +
  scale_fill_manual(values = c(setosa = "#66C2A5", versicolor = "#FC8D62", virginica = "#8DA0CB"), guide = "none") +
  labs(x = NULL, y = "Sepal width (cm)") +
  theme_classic(base_size = 12)

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")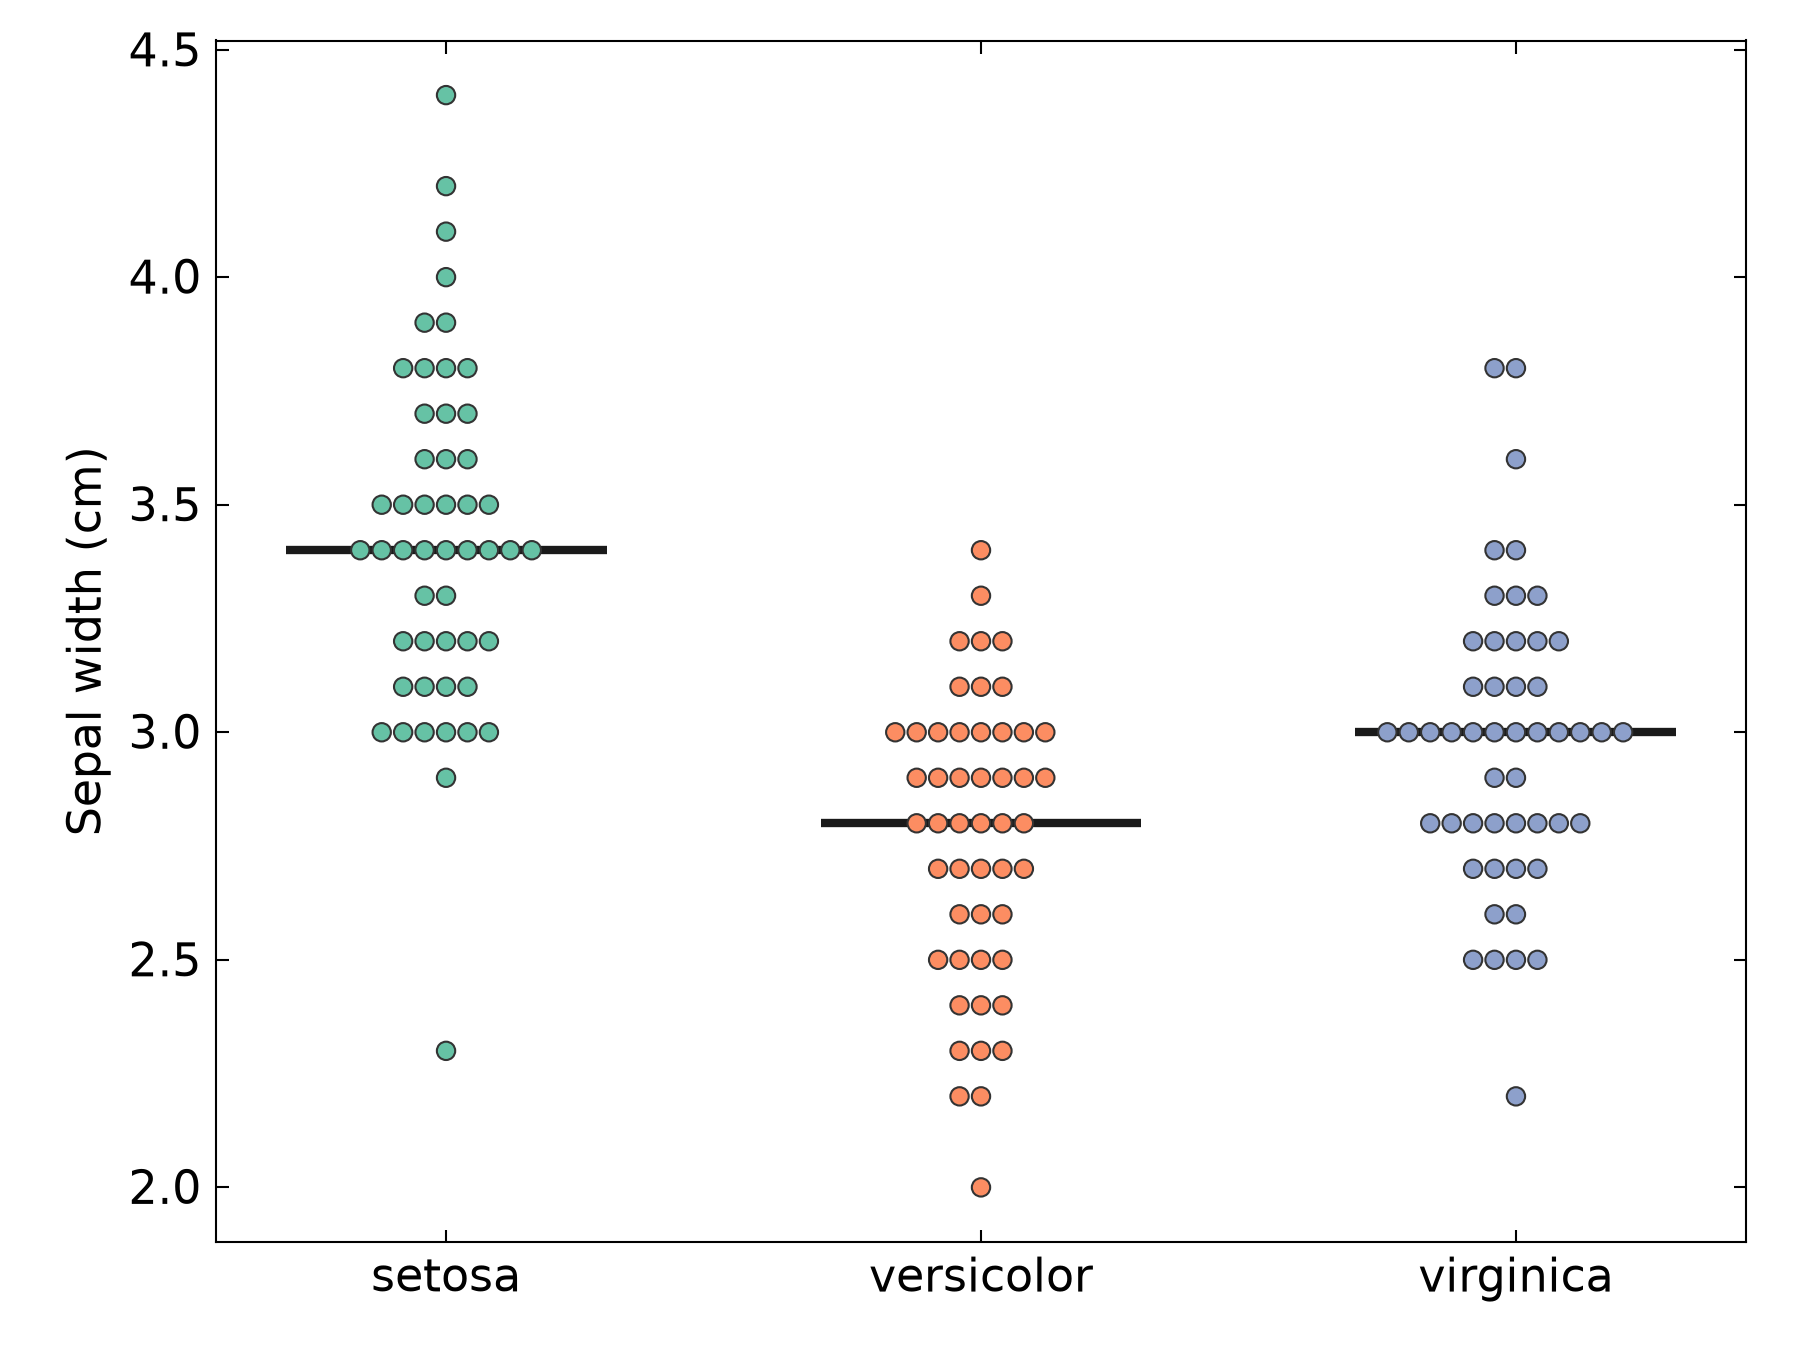
code/py/main.py
import warnings

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import scienceplots  # noqa: F401

plt.style.use(["science", "no-latex"])
plt.rcParams.update({"font.family": "sans-serif", "font.size": 11})  # 与 R 版(theme_classic 无衬线)统一
plt.rcParams["savefig.bbox"] = "standard"                            # scienceplots 默认裁白边,这里保持 6×4.5 in 画布

d = pd.read_csv("data/iris_sepal_width.csv")
sp = ["setosa", "versicolor", "virginica"]
pal = dict(zip(sp, ["#66C2A5", "#FC8D62", "#8DA0CB"]))

rows = ([(f"{s}_n", str((d.Species == s).sum())) for s in sp] +
        [(f"{s}_median", f"{d.loc[d.Species == s, 'Sepal.Width'].median():.4f}") for s in sp] +
        [(f"{s}_mean", f"{d.loc[d.Species == s, 'Sepal.Width'].mean():.4f}") for s in sp])
pd.DataFrame(rows, columns=["item", "value"]).to_csv("outputs/stats_py.csv", index=False)

# swarm 图:点按 y 值排布,互不重叠地向两侧展开(确定性算法,无随机)
fig, ax = plt.subplots(figsize=(6, 4.5))
with warnings.catch_warnings():
    warnings.simplefilter("error", UserWarning)        # 若点放不下(seaborn 会警告),直接报错而不是悄悄重叠
    sns.swarmplot(data=d, x="Species", y="Sepal.Width", order=sp, hue="Species", hue_order=sp, palette=pal,
                  size=4.4, edgecolor="#333333", linewidth=0.5, legend=False, ax=ax)
for i, s in enumerate(sp):
    m = d.loc[d.Species == s, "Sepal.Width"].median()
    ax.hlines(m, i - 0.3, i + 0.3, color="#1A1A1A", lw=2.0, zorder=0.5)   # 线在点下层,不压住取值等于中位数的点
ax.set_xlabel("")
ax.set_ylabel("Sepal width (cm)")
ax.tick_params(axis="x", which="minor", bottom=False, top=False)
ax.minorticks_off()
fig.subplots_adjust(left=0.12, right=0.97, bottom=0.08, top=0.97)
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 每组样本量不大(几十个以内),希望把所有数据点展示出来
- 数据有很多相同取值(离散、四舍五入),普通散点会叠在一起
- 想比箱线图更完整地展示分布,同时用横线标出中位数
常见误用
- 横向位置没有数值含义,只是为了减少重叠;两版的算法不同(R 版 sina:宽度按密度展开,位置带随机错开,固定种子;Python 版 swarm:按 y 值确定性排布),所以两张图点的横向位置不可比,只有纵向取值与分布形状可比
- 样本量很大时点会铺满画面,蜂群或 sina 都不适用,应改用小提琴图、箱线图或密度图;点太大时蜂群会向两侧过度展开,点太小则难看清
- 展示的是原始点和中位数,没有做任何组间检验,不能凭图形直接下“有差异”或“无差异”的结论
- 本例花萼宽度只记录到 0.1 cm,取值有大量重复,点在纵向呈整齐的层,这是测量精度的反映,不是分布的真实形状
数据与下载
数据:R 内置数据集 iris(datasets 包)(R 内置数据集(随 R 分发,GPL-2 | GPL-3))。Anderson(1935)采集、Fisher(1936)使用的鸢尾花数据,3 个物种(setosa、versicolor、virginica)各 50 朵。本例画花萼宽度 Sepal.Width(cm)按物种的分布,黑色横线为各组中位数。R 版使用 ggforce 的 geom_sina(随机错开,seed = 1),Python 版使用 seaborn 的 swarmplot,两者算法不同,点的横向位置不可比;各组样本量、中位数和均值见 outputs/stats_*.csv,两版一致。
下载包 sha256:c2bcf59a30a95dbe9ca67f77ef68531464c3a451e58df4a74bc102e95c18e2db