山脊图(多组分布叠排)
GAL-0020
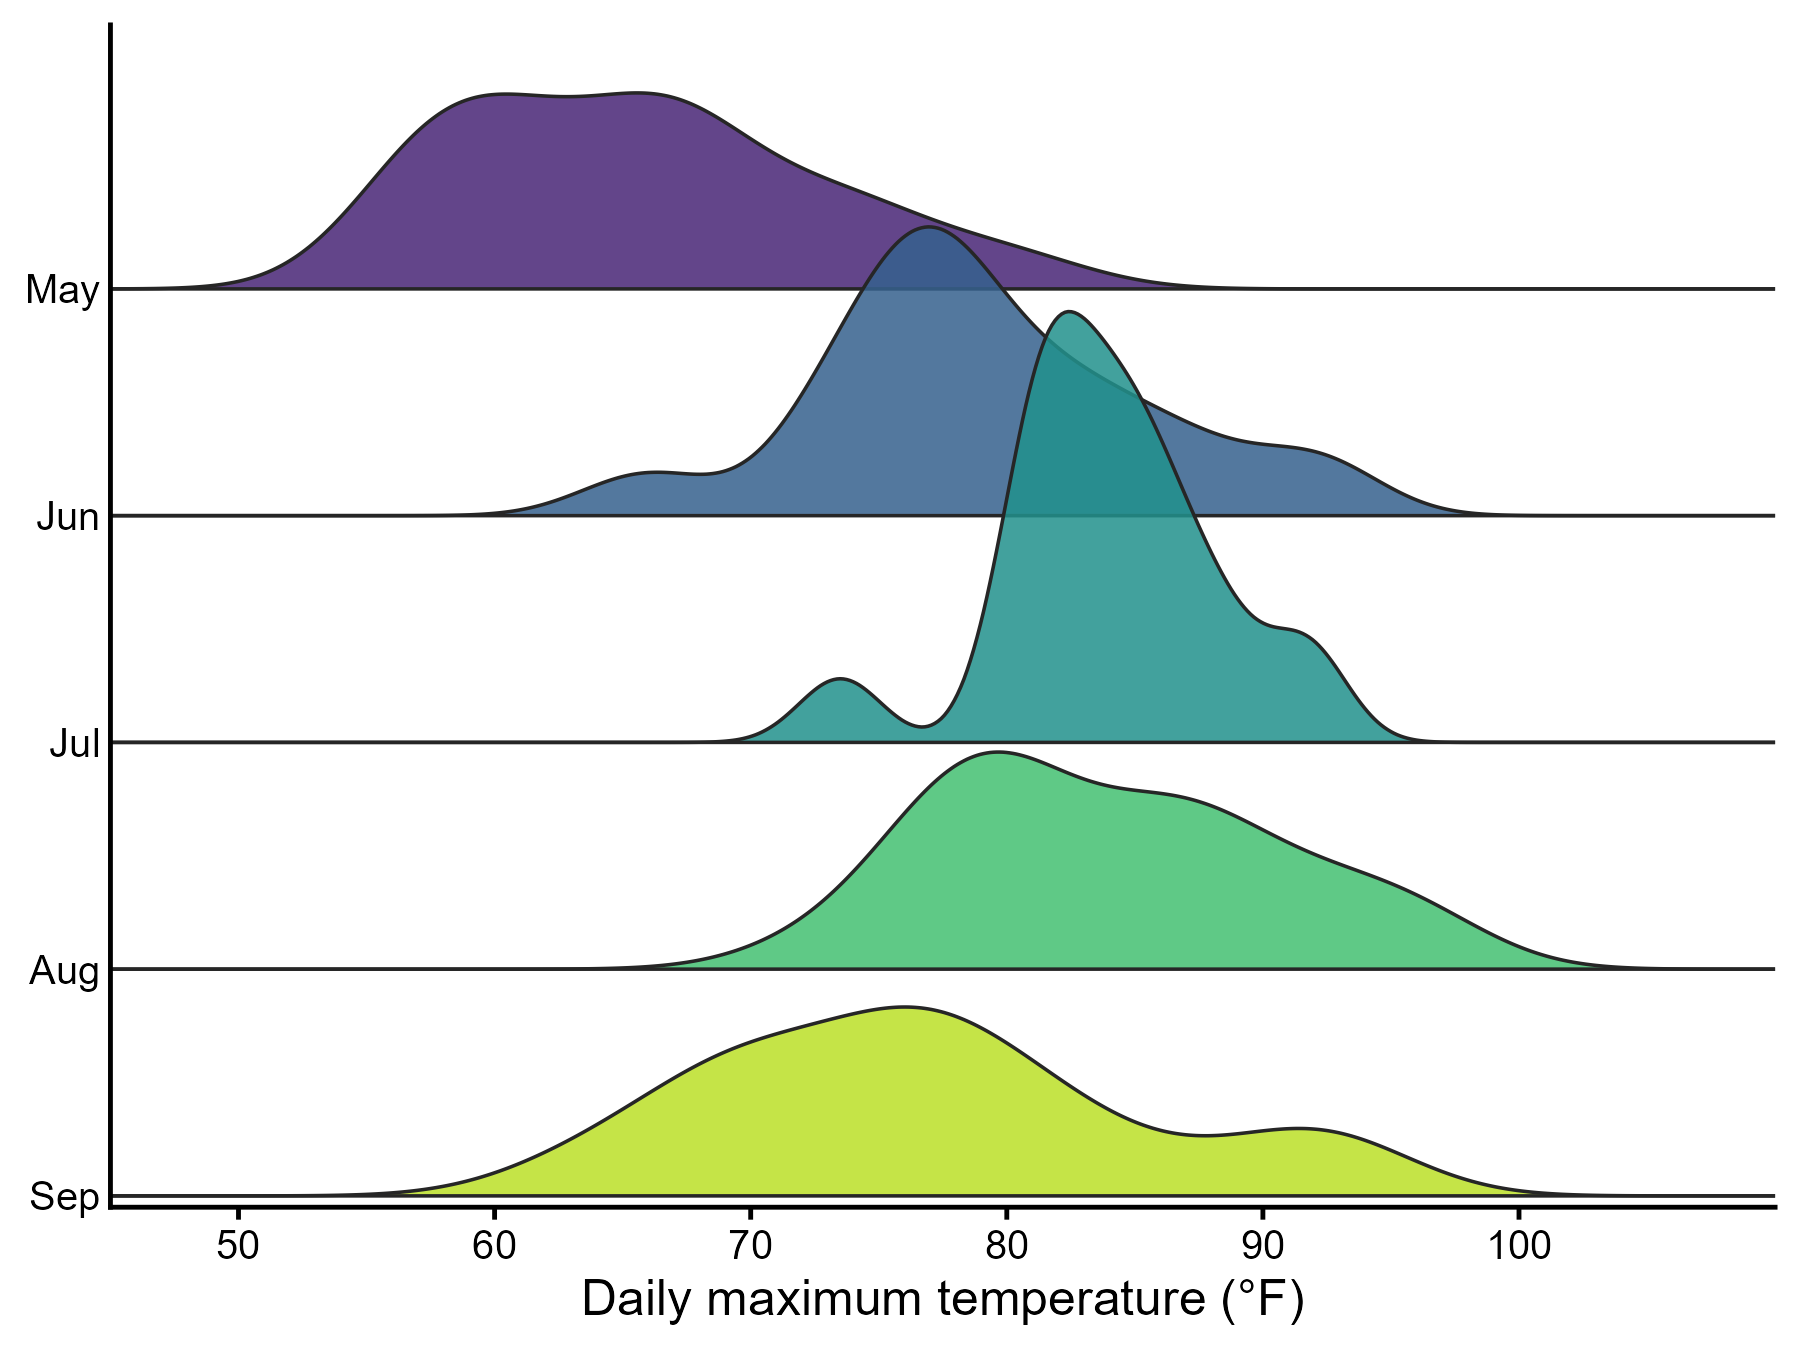
把每个组的密度曲线沿纵向错开叠排,共用同一条横轴,便于一眼比较多个组的分布位置、宽度和形状随组别(如月份)的变化。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))

d <- read.csv("data/airquality_temp.csv", encoding = "UTF-8")
months <- 5:9
mname <- c("May", "Jun", "Jul", "Aug", "Sep")
cols <- c("#482576", "#35608D", "#21908C", "#43BF71", "#BBDF27")   # viridis 5 色(begin = 0.1, end = 0.9)
grid_lo <- 45; grid_hi <- 110; n_grid <- 512                        # 两版共用的评估网格
gap <- 1                                                             # 相邻月份基线间距

# 每个月用自己的 Silverman 经验带宽 bw.nrd0 = 0.9·min(SD, IQR/1.34)·n^(-1/5),高斯核
dens <- lapply(months, function(m) density(d$Temp[d$Month == m], bw = "nrd0", kernel = "gaussian",
                                           from = grid_lo, to = grid_hi, n = n_grid))
scale_k <- 1.9 / max(sapply(dens, function(z) max(z$y)))             # 全体共用一个缩放系数(面积可比),最高峰约 1.9 个间距
rib <- list(); st <- list()
for (i in seq_along(months)) {
  x <- d$Temp[d$Month == months[i]]; dn <- dens[[i]]
  base <- (length(months) - i) * gap                                  # May 在最上,Sep 在最下
  rib[[i]] <- data.frame(x = dn$x, ymin = base, ymax = base + dn$y * scale_k, month = mname[i], base = base)
  st[[i]] <- data.frame(item = paste0(mname[i], c("_n", "_bw", "_mean", "_mode_x")),
                        value = c(length(x), sprintf("%.4f", dn$bw), sprintf("%.4f", mean(x)), sprintf("%.4f", dn$x[which.max(dn$y)])))
}
write.csv(do.call(rbind, st), "outputs/stats_r.csv", row.names = FALSE, quote = FALSE)

p <- ggplot() +
  scale_x_continuous(limits = c(grid_lo, grid_hi), breaks = seq(50, 100, 10), expand = expansion(mult = 0)) +
  scale_y_continuous(breaks = (length(months) - seq_along(months)) * gap, labels = mname, expand = expansion(add = c(0.05, 0.3))) +
  labs(x = "Daily maximum temperature (°F)", y = NULL) +
  theme_classic(base_size = 12) +
  theme(axis.ticks.y = element_blank())
for (i in seq_along(months)) {                                       # 先画最上面的 May,后画的盖在前面
  p <- p + geom_ribbon(data = rib[[i]], aes(x = x, ymin = ymin, ymax = ymax), fill = cols[i], colour = "grey15",
                       linewidth = 0.4, alpha = 0.85)
}

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")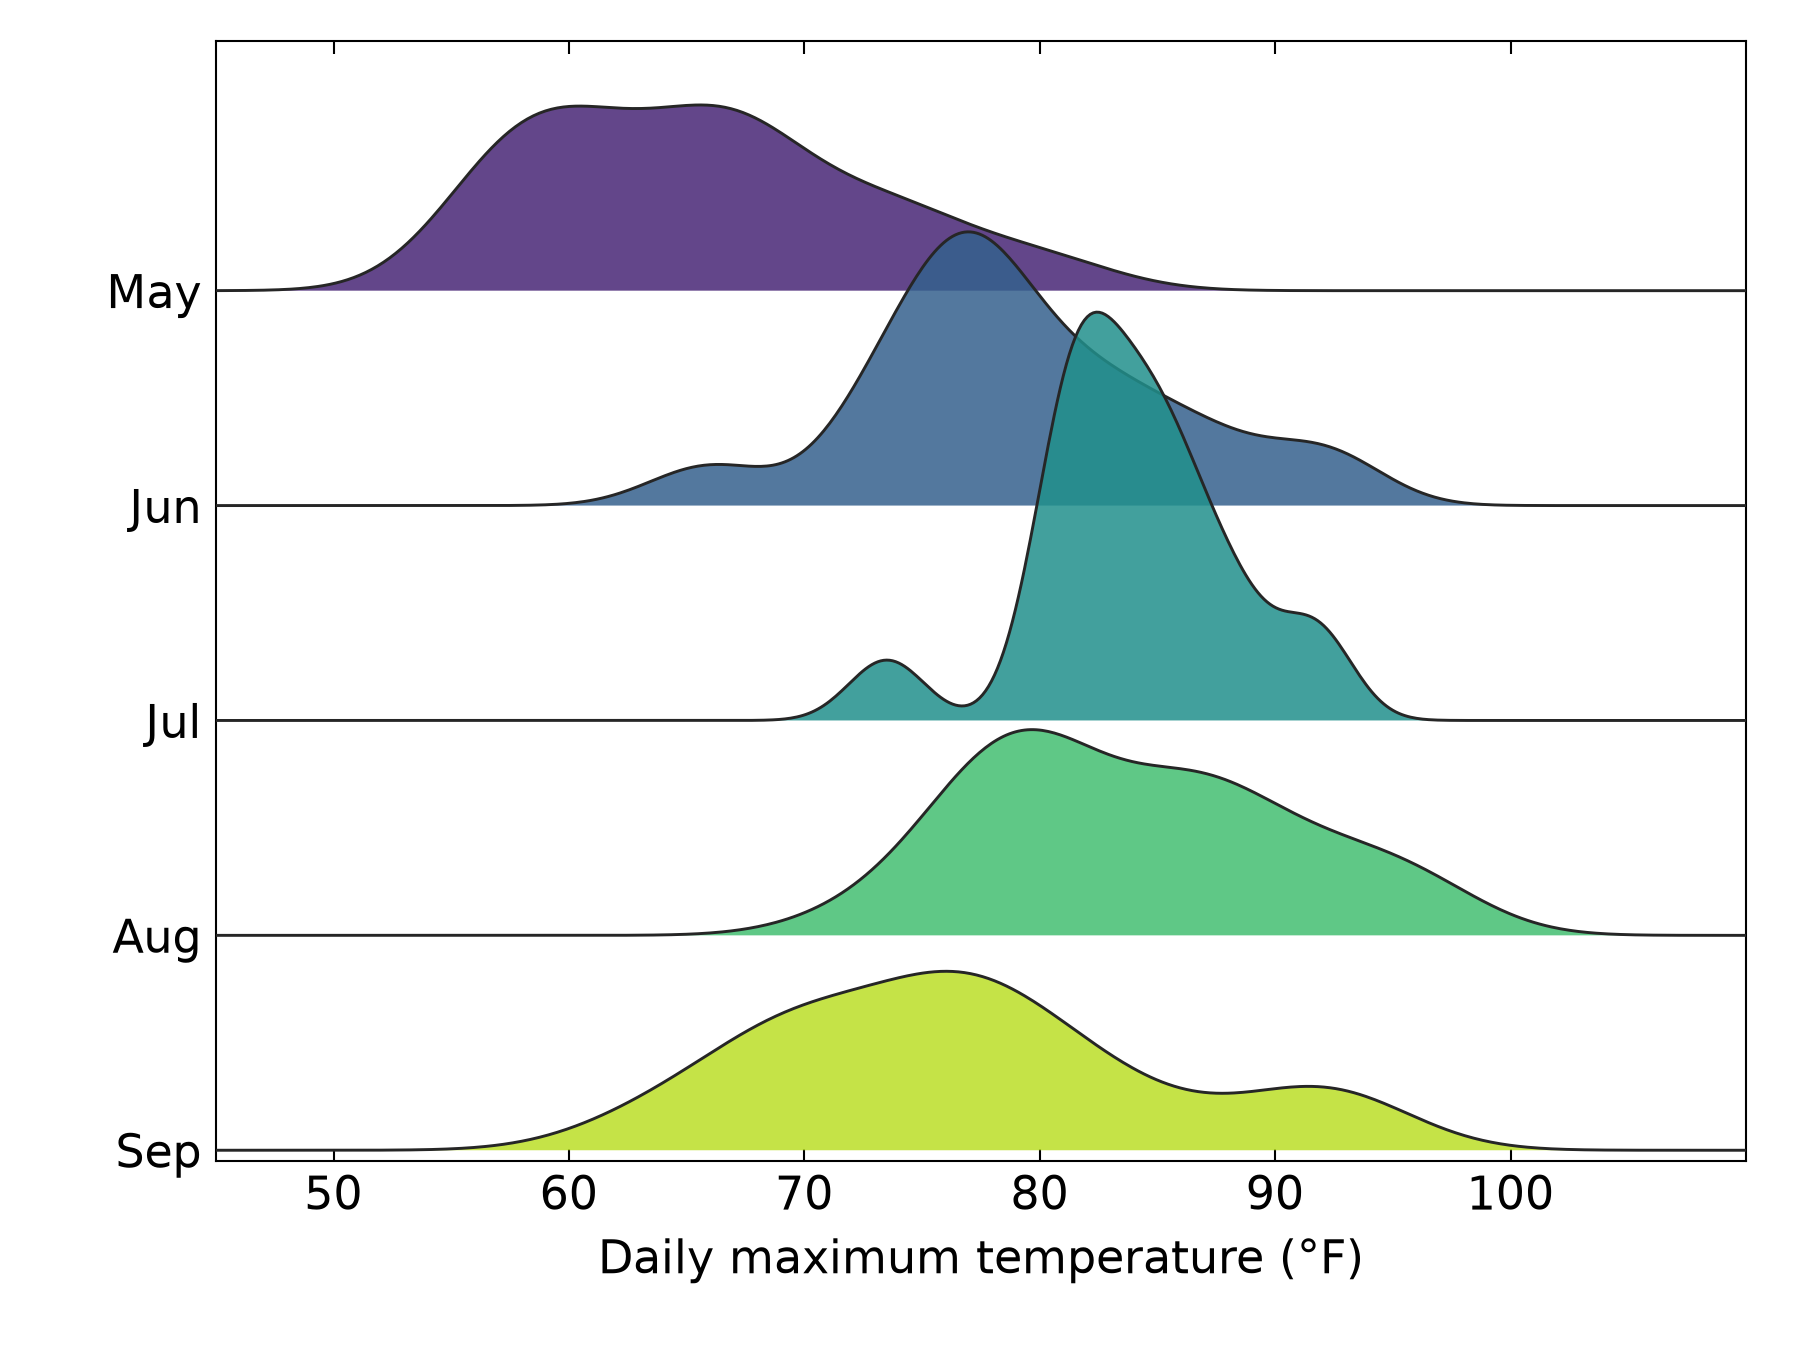
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots  # noqa: F401
from scipy.stats import gaussian_kde

plt.style.use(["science", "no-latex"])
plt.rcParams.update({"font.family": "sans-serif", "font.size": 11})  # 与 R 版(theme_classic 无衬线)统一
plt.rcParams["savefig.bbox"] = "standard"                            # scienceplots 默认裁白边,这里保持 6×4.5 in 画布

d = pd.read_csv("data/airquality_temp.csv")
months = [5, 6, 7, 8, 9]
mname = ["May", "Jun", "Jul", "Aug", "Sep"]
cols = ["#482576", "#35608D", "#21908C", "#43BF71", "#BBDF27"]       # viridis 5 色(begin = 0.1, end = 0.9)
grid_lo, grid_hi, n_grid = 45, 110, 512                               # 两版共用的评估网格
gap = 1.0


def bw_nrd0(x):
    """R 的 bw.nrd0:0.9·min(SD, IQR/1.34)·n^(-1/5)(IQR 用 type 7 分位数,与 numpy 默认一致)。"""
    sd = np.std(x, ddof=1)
    iqr = np.subtract(*np.percentile(x, [75, 25]))
    lo = min(sd, iqr / 1.34)
    return 0.9 * lo * len(x) ** (-0.2)


grid = np.linspace(grid_lo, grid_hi, n_grid)
xs = [d.loc[d.Month == m, "Temp"].to_numpy(float) for m in months]
bws = [bw_nrd0(x) for x in xs]
# scipy 的 bw_method 标量 = 带宽 / 样本 SD,换算后与 R 的绝对带宽一致
dens = [gaussian_kde(x, bw_method=b / np.std(x, ddof=1))(grid) for x, b in zip(xs, bws)]
scale_k = 1.9 / max(y.max() for y in dens)                            # 全体共用一个缩放系数(面积可比),最高峰约 1.9 个间距

fig, ax = plt.subplots(figsize=(6, 4.5))
rows = []
ytop = 0.0
for i, (x, bw, y) in enumerate(zip(xs, bws, dens)):
    base = (len(months) - 1 - i) * gap                                # May 在最上,Sep 在最下
    ytop = max(ytop, base + y.max() * scale_k)
    z = 10 + i                                                        # 先画的 May 在最底层,后画的盖在前面
    ax.fill_between(grid, base, base + y * scale_k, facecolor=cols[i], edgecolor="none", alpha=0.85, zorder=z)
    ax.plot(grid, base + y * scale_k, color="#262626", lw=0.7, zorder=z + 0.5)
    rows += [(f"{mname[i]}_n", str(len(x))), (f"{mname[i]}_bw", f"{bw:.4f}"), (f"{mname[i]}_mean", f"{x.mean():.4f}"),
             (f"{mname[i]}_mode_x", f"{grid[np.argmax(y)]:.4f}")]
pd.DataFrame(rows, columns=["item", "value"]).to_csv("outputs/stats_py.csv", index=False)

ax.set_xlim(grid_lo, grid_hi)
ax.set_xticks(range(50, 101, 10))
ax.set_yticks([(len(months) - 1 - i) * gap for i in range(len(months))])
ax.set_yticklabels(mname)
ax.set_ylim(-0.05, ytop + 0.3)
ax.tick_params(axis="y", which="both", length=0)
ax.minorticks_off()
ax.set_xlabel("Daily maximum temperature (°F)")
fig.subplots_adjust(left=0.12, right=0.97, bottom=0.14, top=0.97)
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 组数较多(5 组以上)时比较分布,直方图叠在一起会过于拥挤
- 分组有自然顺序(时间、剂量、年龄段),关心分布随顺序的移动
- 想比较分布的位置与离散,而不是每个个体
常见误用
- 密度曲线是平滑估计,会受带宽影响,在数据范围之外也会拖出尾巴;本例带宽用 Silverman 经验规则(bw.nrd0),并且每组各算各的,样本量只有 30 左右时曲线的细节不宜过度解读
- 各组用同一个缩放系数,曲线高度可比;若每组各自缩放到同样高度,则只能比较形状,不能比较高度
- 相邻曲线上下互相覆盖只是排版效果(为了紧凑),会遮住后面曲线的一部分,本身不含统计信息;各月分布在横轴上重叠得多,通常提示差异小,但差异大小和是否显著仍要用统计检验或区间估计回答
- 山脊图不显示样本量和原始点,需要时在轴标签中标注 n,或叠加数据点
数据与下载
数据:R 内置数据集 airquality(datasets 包)(R 内置数据集(随 R 分发,GPL-2 | GPL-3))。1973 年 5~9 月纽约的每日空气质量测量,本例取每日最高气温 Temp(华氏度)按月份(5~9 月,n = 31、30、31、31、30,Temp 无缺失)画密度曲线。R 用 density() 加 geom_ribbon 自绘(不装 ggridges),Python 用 scipy.stats.gaussian_kde;两版都用高斯核、每月各自的 Silverman 带宽 bw.nrd0 = 0.9 × min(SD, IQR/1.34) × n^(-1/5)(Python 里换算成 gaussian_kde 的带宽因子),在 45~110 的同一 512 点网格上计算,并共用同一个高度缩放系数。各月带宽、均值和峰位见 outputs/stats_*.csv。
下载包 sha256:6ad35b2fd8db7322ae58f81de12a977e76e8616b91d05131fd14667f34ef5d4e