配对前后对比图(连线点图)
GAL-0019
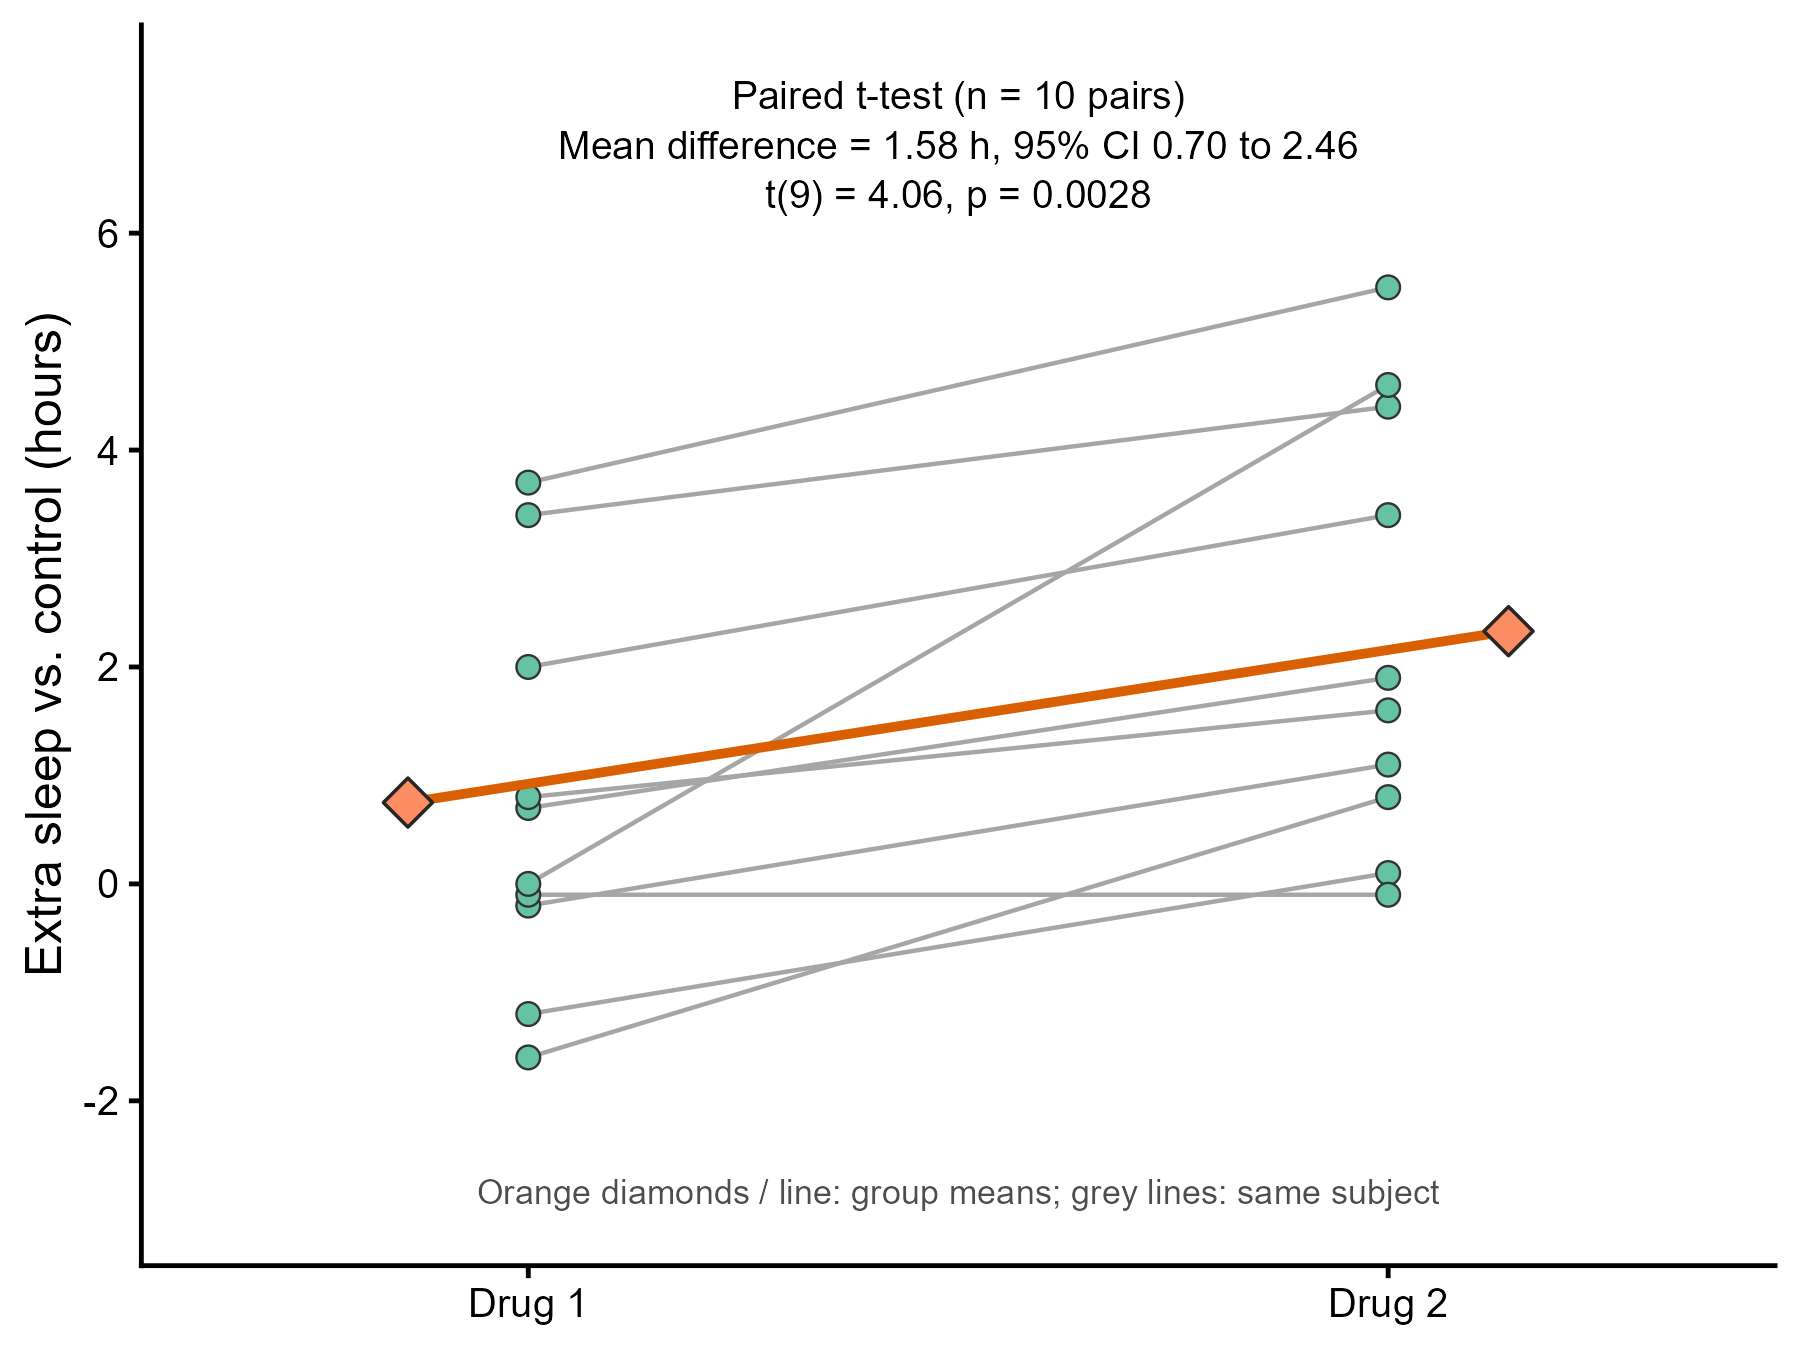
同一批对象在两种条件下各测一次,把每个对象的两个测量值用线连起来,叠加两个条件的均值,直观看到每个个体的变化方向和幅度,并配合配对 t 检验给出差值的估计。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))

d <- read.csv("data/sleep.csv", encoding = "UTF-8")
w <- merge(d[d$group == 1, c("ID", "extra")], d[d$group == 2, c("ID", "extra")], by = "ID", suffixes = c("_1", "_2"))
w <- w[order(w$ID), ]

# 配对 t 检验:按 ID 配对,差值 = 药物 2 − 药物 1
tt <- t.test(w$extra_2, w$extra_1, paired = TRUE)
write.csv(data.frame(item = c("n_pairs", "mean_1", "mean_2", "mean_diff", "sd_diff", "t", "df", "p", "ci_lo", "ci_hi"),
                     value = c(nrow(w), sprintf("%.4f", mean(w$extra_1)), sprintf("%.4f", mean(w$extra_2)),
                               sprintf("%.4f", unname(tt$estimate)), sprintf("%.4f", sd(w$extra_2 - w$extra_1)),
                               sprintf("%.4f", unname(tt$statistic)), sprintf("%.0f", unname(tt$parameter)),
                               sprintf("%.6f", tt$p.value), sprintf("%.4f", tt$conf.int[1]), sprintf("%.4f", tt$conf.int[2]))),
          "outputs/stats_r.csv", row.names = FALSE, quote = FALSE)
# p 值显示:< 0.001 写“< 0.001”;0.001~0.01 保留 2 位有效数字(如 0.0028);其余 3 位小数
ptxt <- if (tt$p.value < 0.001) "p < 0.001" else if (tt$p.value < 0.01) sprintf("p = %.4f", signif(tt$p.value, 2)) else sprintf("p = %.3f", tt$p.value)
note <- sprintf("Paired t-test (n = %d pairs)\nMean difference = %.2f h, 95%% CI %.2f to %.2f\nt(%d) = %.2f, %s",
                nrow(w), unname(tt$estimate), tt$conf.int[1], tt$conf.int[2], unname(tt$parameter), unname(tt$statistic), ptxt)

d$drug <- factor(d$group, levels = 1:2, labels = c("Drug 1", "Drug 2"))
m <- aggregate(extra ~ drug, d, mean)
m$x <- as.numeric(m$drug) + c(-0.14, 0.14)        # 均值菱形向外错开,不遮住个体点

p <- ggplot(d, aes(x = drug, y = extra)) +
  geom_line(aes(group = ID), colour = "grey65", linewidth = 0.5) +
  geom_point(shape = 21, size = 2.4, fill = "#66C2A5", colour = "grey20", stroke = 0.4) +
  geom_line(data = m, aes(x = x, group = 1), colour = "#D95F02", linewidth = 1.1) +
  geom_point(data = m, aes(x = x), shape = 23, size = 4, fill = "#FC8D62", colour = "grey15", stroke = 0.6) +
  annotate("text", x = 1.5, y = 7.4, label = note, size = 3.3, lineheight = 1.05, vjust = 1) +
  annotate("text", x = 1.5, y = -2.95, label = "Orange diamonds / line: group means; grey lines: same subject",
           size = 2.9, colour = "grey30", vjust = 0) +
  scale_x_discrete(expand = expansion(add = 0.45)) +
  scale_y_continuous(limits = c(-3, 7.4), breaks = seq(-2, 6, 2)) +
  labs(x = NULL, y = "Extra sleep vs. control (hours)") +
  theme_classic(base_size = 12)

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")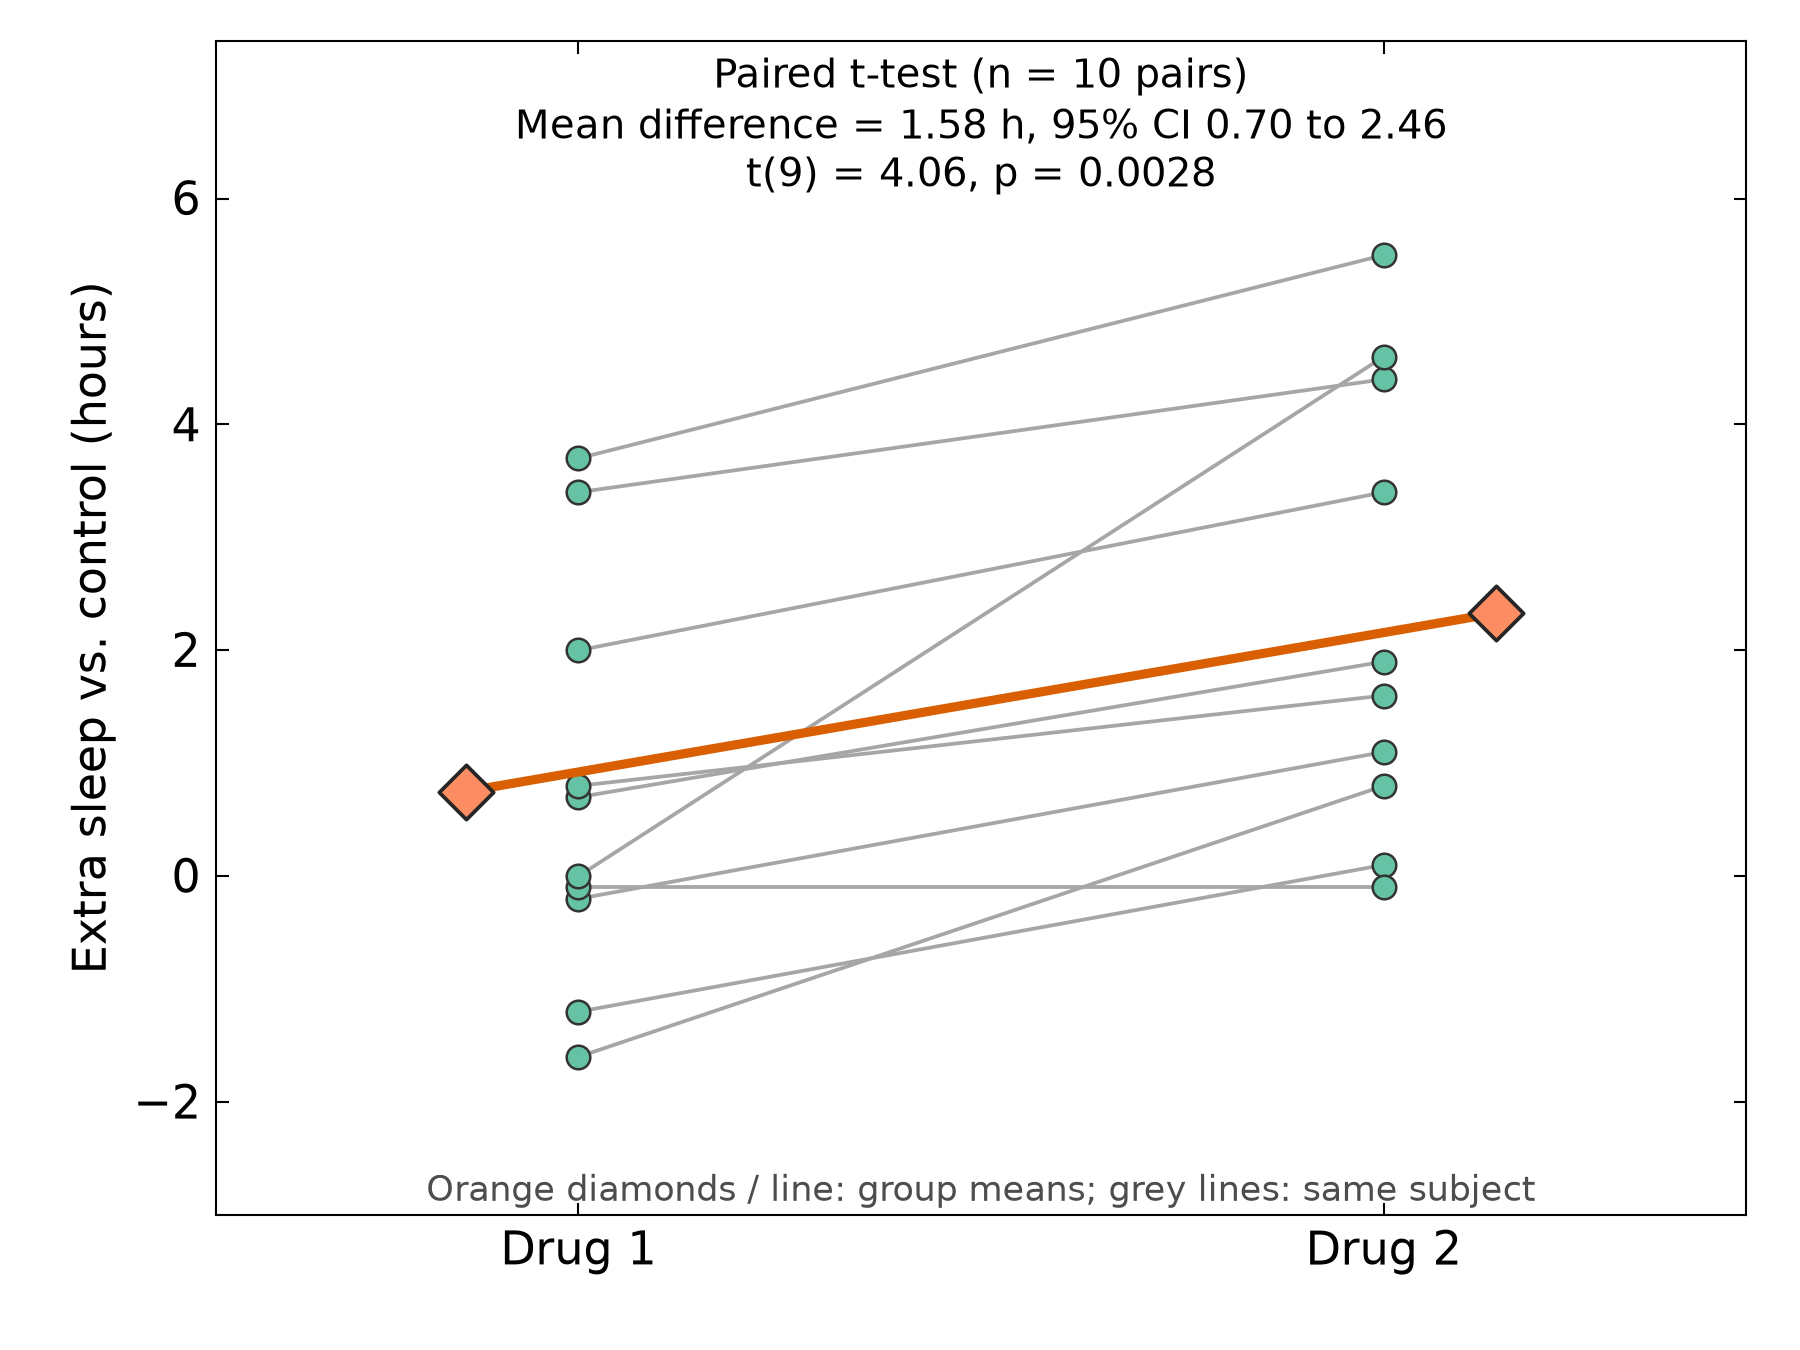
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots  # noqa: F401
from scipy import stats

plt.style.use(["science", "no-latex"])
plt.rcParams.update({"font.family": "sans-serif", "font.size": 11})  # 与 R 版(theme_classic 无衬线)统一
plt.rcParams["savefig.bbox"] = "standard"                            # scienceplots 默认裁白边,这里保持 6×4.5 in 画布

d = pd.read_csv("data/sleep.csv")
w = d[d.group == 1].set_index("ID")[["extra"]].join(d[d.group == 2].set_index("ID")[["extra"]], lsuffix="_1", rsuffix="_2").sort_index()

# 配对 t 检验:按 ID 配对,差值 = 药物 2 − 药物 1
tt = stats.ttest_rel(w["extra_2"], w["extra_1"])
ci = tt.confidence_interval(0.95)
diff = w["extra_2"] - w["extra_1"]
vals = [len(w), w.extra_1.mean(), w.extra_2.mean(), diff.mean(), diff.std(ddof=1), tt.statistic, tt.df, tt.pvalue, ci.low, ci.high]
items = ["n_pairs", "mean_1", "mean_2", "mean_diff", "sd_diff", "t", "df", "p", "ci_lo", "ci_hi"]
fmt = lambda k, v: str(int(v)) if k == "n_pairs" else (f"{v:.0f}" if k == "df" else (f"{v:.6f}" if k == "p" else f"{v:.4f}"))
pd.DataFrame({"item": items, "value": [fmt(k, v) for k, v in zip(items, vals)]}).to_csv("outputs/stats_py.csv", index=False)
# p 值显示:< 0.001 写“< 0.001”;0.001~0.01 保留 2 位有效数字(如 0.0028);其余 3 位小数
ptxt = ("p < 0.001" if tt.pvalue < 0.001 else
        f"p = {float(f'{tt.pvalue:.2g}'):.4f}" if tt.pvalue < 0.01 else f"p = {tt.pvalue:.3f}")
note = (f"Paired t-test (n = {len(w)} pairs)\nMean difference = {diff.mean():.2f} h, 95% CI {ci.low:.2f} to {ci.high:.2f}\n"
        f"t({int(tt.df)}) = {tt.statistic:.2f}, {ptxt}")

fig, ax = plt.subplots(figsize=(6, 4.5))
for _, r in w.iterrows():
    ax.plot([1, 2], [r.extra_1, r.extra_2], color="#A6A6A6", lw=0.9, zorder=1)
ax.scatter(np.ones(len(w)), w.extra_1, s=32, facecolor="#66C2A5", edgecolor="#333333", linewidth=0.6, zorder=3)
ax.scatter(np.full(len(w), 2), w.extra_2, s=32, facecolor="#66C2A5", edgecolor="#333333", linewidth=0.6, zorder=3)
mx = [1 - 0.14, 2 + 0.14]   # 均值菱形向外错开,不遮住个体点
ax.plot(mx, [w.extra_1.mean(), w.extra_2.mean()], color="#D95F02", lw=2.2, zorder=4)
ax.scatter(mx, [w.extra_1.mean(), w.extra_2.mean()], s=85, marker="D", facecolor="#FC8D62", edgecolor="#262626", linewidth=0.9, zorder=5)
ax.text(1.5, 7.3, note, ha="center", va="top", fontsize=9.5, linespacing=1.25)
ax.text(1.5, -2.95, "Orange diamonds / line: group means; grey lines: same subject", ha="center", va="bottom", fontsize=8.5, color="#4D4D4D")

ax.set_xlim(0.55, 2.45)
ax.set_ylim(-3, 7.4)
ax.set_xticks([1, 2])
ax.set_xticklabels(["Drug 1", "Drug 2"])
ax.set_yticks(range(-2, 7, 2))
ax.set_ylabel("Extra sleep vs. control (hours)")
ax.minorticks_off()
fig.subplots_adjust(left=0.12, right=0.97, bottom=0.10, top=0.97)
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 同一批受试者前后(或两种处理下)重复测量的比较
- 想同时看总体趋势和每个个体的变化是否一致
- 样本量较小(本例 10 对),可以展示每个个体
常见误用
- 配对数据必须按配对关系分析(配对 t 检验或其非参数替代),把两组当作独立样本做两样本 t 检验会丢掉配对信息、检验效能偏低
- 配对 t 检验假设“差值”近似正态;样本量小时要看差值的分布,必要时用 Wilcoxon 符号秩检验作敏感性分析
- 图中的两个均值只是各自的平均,检验和置信区间针对的是配对差值(药物 2 − 药物 1)的均值;本例差值 95% 置信区间不含 0,不等于药效在每个个体都成立
- 均值菱形向外错开,橙色均值线因此比灰线跨度大、显得更平缓,读均值以菱形为准,不要比较橙线与灰线的斜率
- 数据没有记录给药顺序和间隔,无法评估顺序或残留效应;数据集只给出相对对照(control)的睡眠增加量,没有说明对照的具体设置,不能据此推断临床疗效
数据与下载
数据:R 内置数据集 sleep(datasets 包)(R 内置数据集(随 R 分发,GPL-2 | GPL-3))。10 名受试者分别服用两种催眠药(drug 1、drug 2)后睡眠时间相对对照的增加量 extra(小时)。数据来自 Cushny 与 Peebles(1905)的试验,被 Student(1908)用于介绍 t 检验。配对结构:每名受试者(ID 1~10)在两种药物下各有一个测量值,共 10 对,按 ID 配对。配对 t 检验的差值取药物 2 − 药物 1,结果由代码计算:R 用 t.test(paired = TRUE),Python 用 scipy.stats.ttest_rel,两版一致(outputs/stats_*.csv)。图上 p 值按全站规则显示(< 0.001 写“< 0.001”,0.001~0.01 保留 2 位有效数字,其余 3 位小数),本例为 0.0028,精确值见 stats 文件。均值菱形画在两列点的外侧(略向左、向右错开),以免遮住取值接近均值的个体点。
下载包 sha256:b87139f2005e80d0b42025cde7c133441d2a6b6ffd7fe234185df26a996b6f95