克利夫兰点图(排序后的单变量比较)
GAL-0018
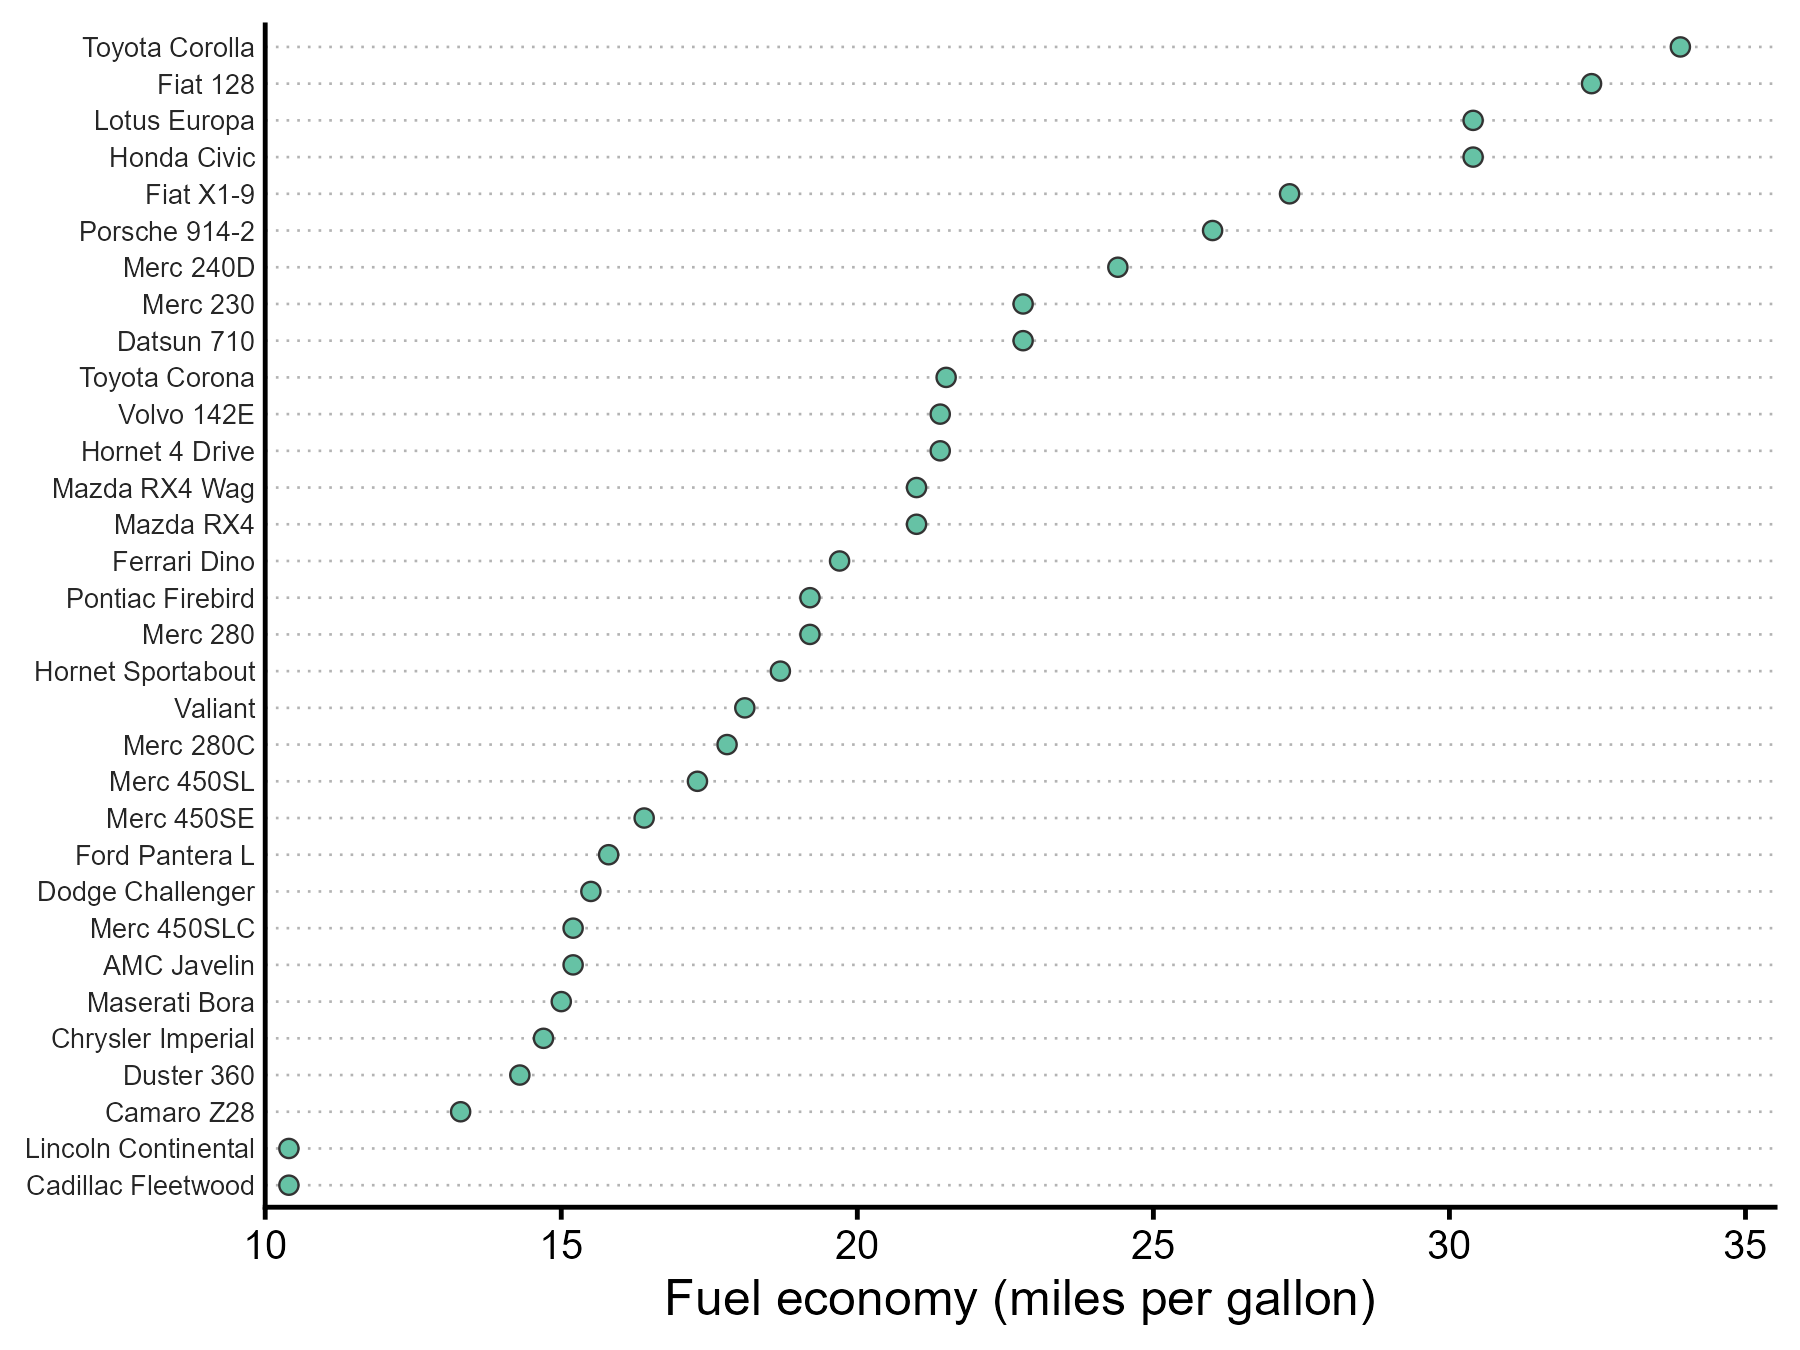
把每个对象的数值画成一个点,按数值从大到小排序,对象名写在纵轴上,横向读数。比同样内容的柱状图更省墨,适合对象多、名字长的排序比较。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))

d <- read.csv("data/mtcars_mpg.csv", encoding = "UTF-8")
# 按 mpg 升序排列,同值按车名(C 区域字节序);最高的在最上面
d <- d[order(d$mpg, d$car, method = "radix"), ]
d$car <- factor(d$car, levels = d$car)
write.csv(data.frame(item = c("n", "min", "max", "mean", "top", "bottom"),
                     value = c(nrow(d), sprintf("%.4f", c(min(d$mpg), max(d$mpg), mean(d$mpg))), as.character(d$car[nrow(d)]), as.character(d$car[1]))),
          "outputs/stats_r.csv", row.names = FALSE, quote = FALSE)

# 克利夫兰点图:位置编码数值,横轴不必从 0 起;浅色点线横贯绘图区,只引导视线对齐车名(线长不表示数值),便于读数
p <- ggplot(d, aes(x = mpg, y = car)) +
  geom_segment(aes(x = 10, xend = Inf, yend = car), colour = "grey70", linewidth = 0.3, linetype = "dotted") +
  geom_point(shape = 21, size = 1.9, fill = "#66C2A5", colour = "grey20", stroke = 0.4) +
  scale_x_continuous(limits = c(10, 35), breaks = seq(10, 35, 5), expand = expansion(mult = c(0, 0.02))) +
  labs(x = "Fuel economy (miles per gallon)", y = NULL) +
  theme_classic(base_size = 12) +
  theme(axis.text.y = element_text(size = 6.5, colour = "grey15"), axis.ticks.y = element_blank())

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")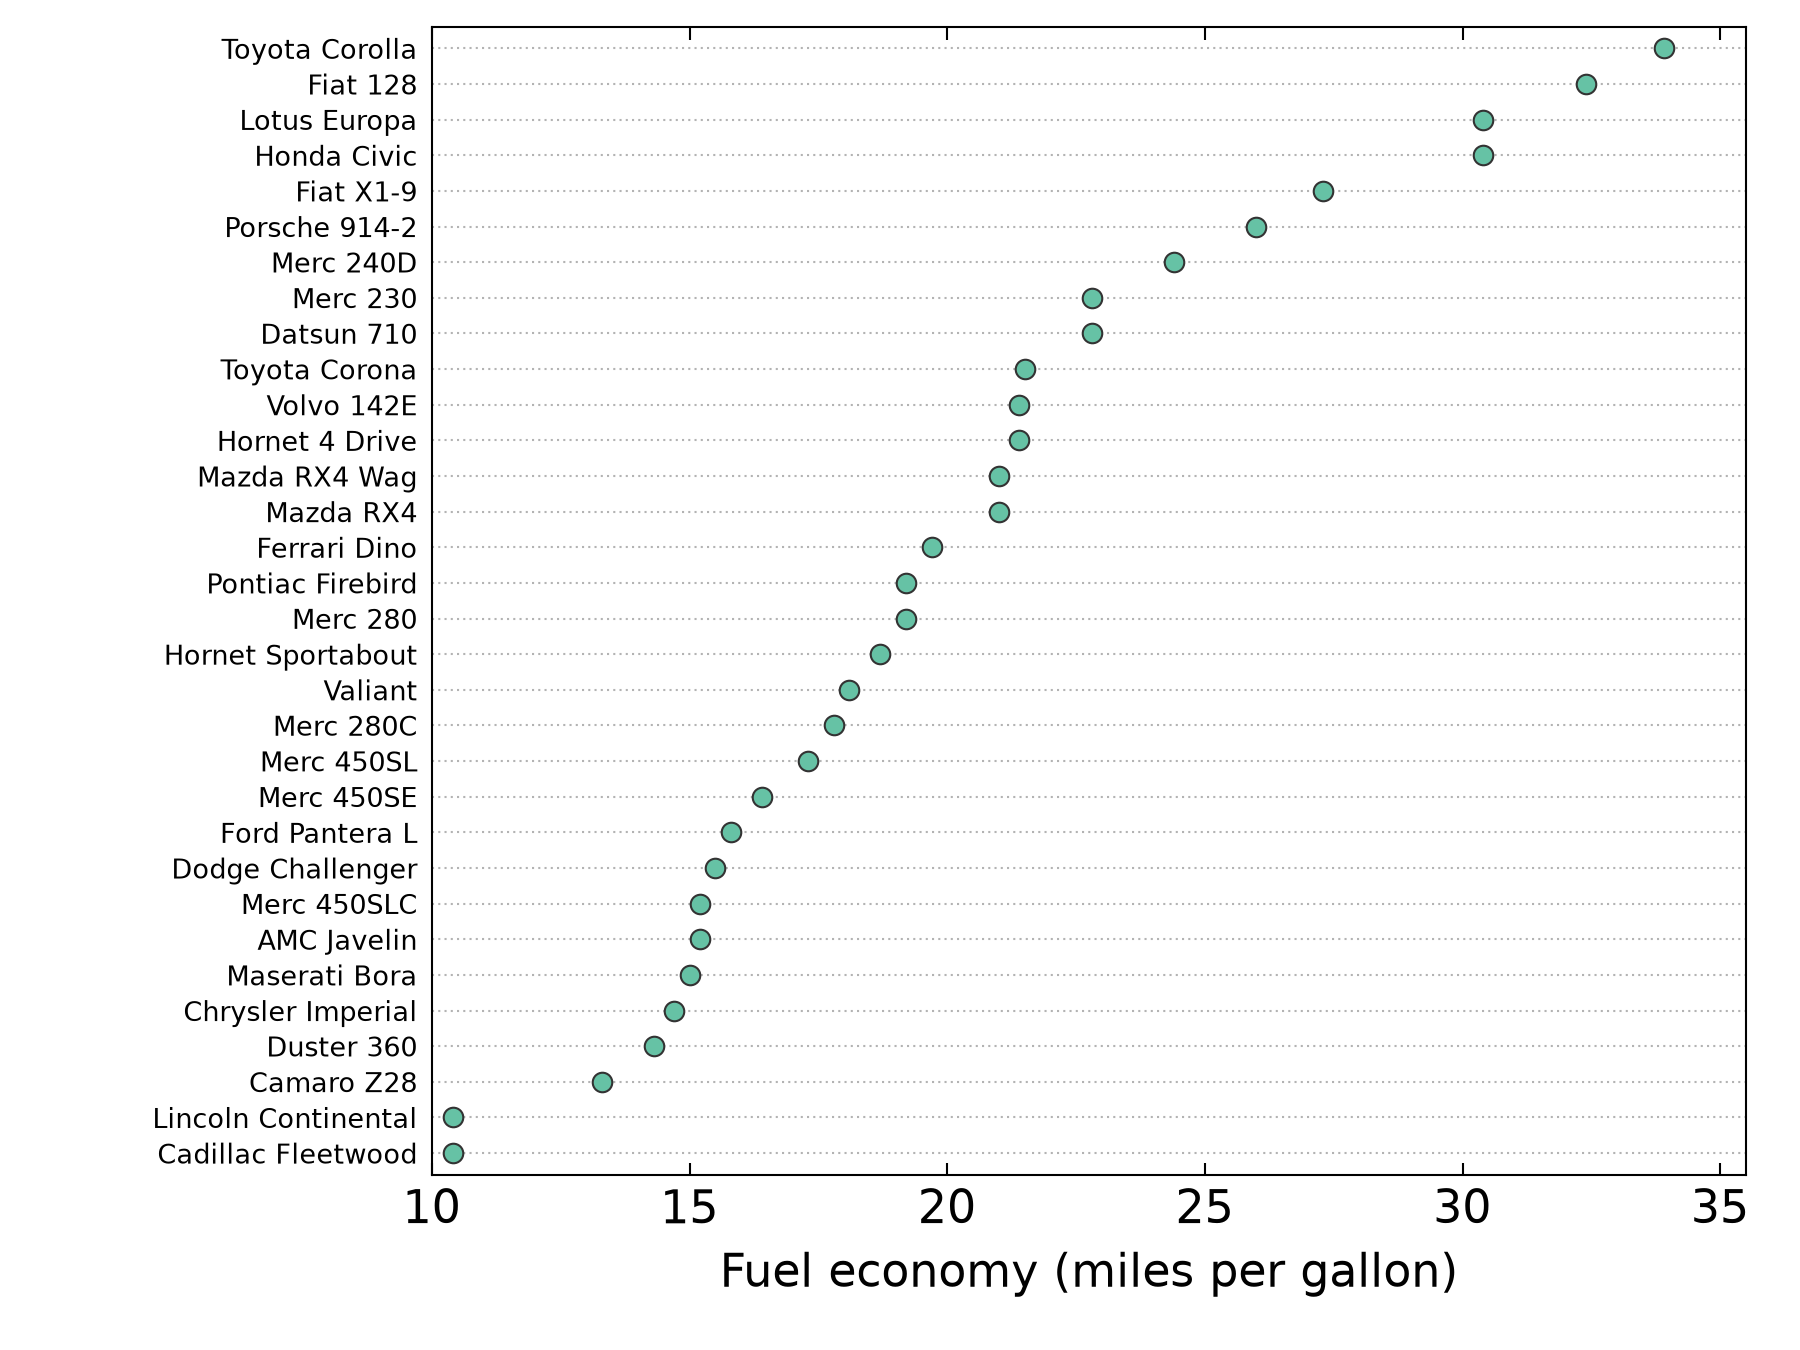
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots  # noqa: F401

plt.style.use(["science", "no-latex"])
plt.rcParams.update({"font.family": "sans-serif", "font.size": 11})  # 与 R 版(theme_classic 无衬线)统一
plt.rcParams["savefig.bbox"] = "standard"                            # scienceplots 默认裁白边,这里保持 6×4.5 in 画布

d = pd.read_csv("data/mtcars_mpg.csv")
# 按 mpg 升序排列,同值按车名(字节序);最高的在最上面
d = d.sort_values(["mpg", "car"], kind="stable").reset_index(drop=True)
pd.DataFrame({"item": ["n", "min", "max", "mean", "top", "bottom"],
              "value": [len(d), f"{d.mpg.min():.4f}", f"{d.mpg.max():.4f}", f"{d.mpg.mean():.4f}", d.car.iloc[-1], d.car.iloc[0]]}
             ).to_csv("outputs/stats_py.csv", index=False)

# 克利夫兰点图:位置编码数值,横轴不必从 0 起;浅色点线横贯绘图区,只引导视线对齐车名(线长不表示数值),便于读数
fig, ax = plt.subplots(figsize=(6, 4.5))
y = np.arange(len(d)) + 1
ax.hlines(y, 10, 35.5, color="#B3B3B3", lw=0.5, linestyles=(0, (1, 2)))
ax.scatter(d["mpg"], y, s=22, facecolor="#66C2A5", edgecolor="#333333", linewidth=0.5, zorder=3)
ax.set_yticks(y)
ax.set_yticklabels(d["car"], fontsize=6.5)
ax.set_ylim(0.4, len(d) + 0.6)
ax.set_xlim(10, 35.5)
ax.set_xticks(range(10, 36, 5))
ax.set_xlabel("Fuel economy (miles per gallon)")
ax.tick_params(axis="y", which="both", length=0)
ax.minorticks_off()
fig.subplots_adjust(left=0.24, right=0.97, bottom=0.13, top=0.98)
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 比较几十个以内的对象在同一个指标上的高低,并要看出名次
- 对象名称较长,横向排列比竖直柱状图更易读
- 数值之间的差异远小于数值本身的量级,不想让柱子占满画面
常见误用
- 点只用位置表示数值,横轴不必从 0 开始,本例从 10 起;但读者要注意轴起点,别把点间距读成相对比例。若改画成棒棒糖图(从 0 起的棍子),棍长表示数值大小,就应该从 0 起轴
- 排序会强调名次,微小的差异也会拉出明显的先后;相近的点(如本例同为 21.0 的车型)不要过度解读,同值按车名排序只是约定
- 本例只比较单一指标 mpg,没有考虑排量、重量、气缸数等混杂因素;不同车型的差异不能直接归因于某一个因素
- 对象很多时(如本例 32 个)字号会变小;超过一屏的对象数建议分组、截取前后若干名,或交互式查看
数据与下载
数据:R 内置数据集 mtcars(datasets 包)(R 内置数据集(随 R 分发,GPL-2 | GPL-3))。1974 年《Motor Trend》杂志的 32 款汽车的油耗与设计参数。本例取每款车的 mpg(每加仑英里数),按 mpg 从高到低纵向排列,同值按车名排序。横轴 10~35;浅色点线按 Cleveland 的做法横贯整个绘图区,只用来引导视线对齐车名,线长不表示数值(若点线只画到点,就成了从 10 起的棒棒糖图,线长会被误读)。
下载包 sha256:bc6115858cc0896a0d715f0443947bd780daad689750ddbd56ade60c16621523