百分比堆叠柱状图
GAL-0017
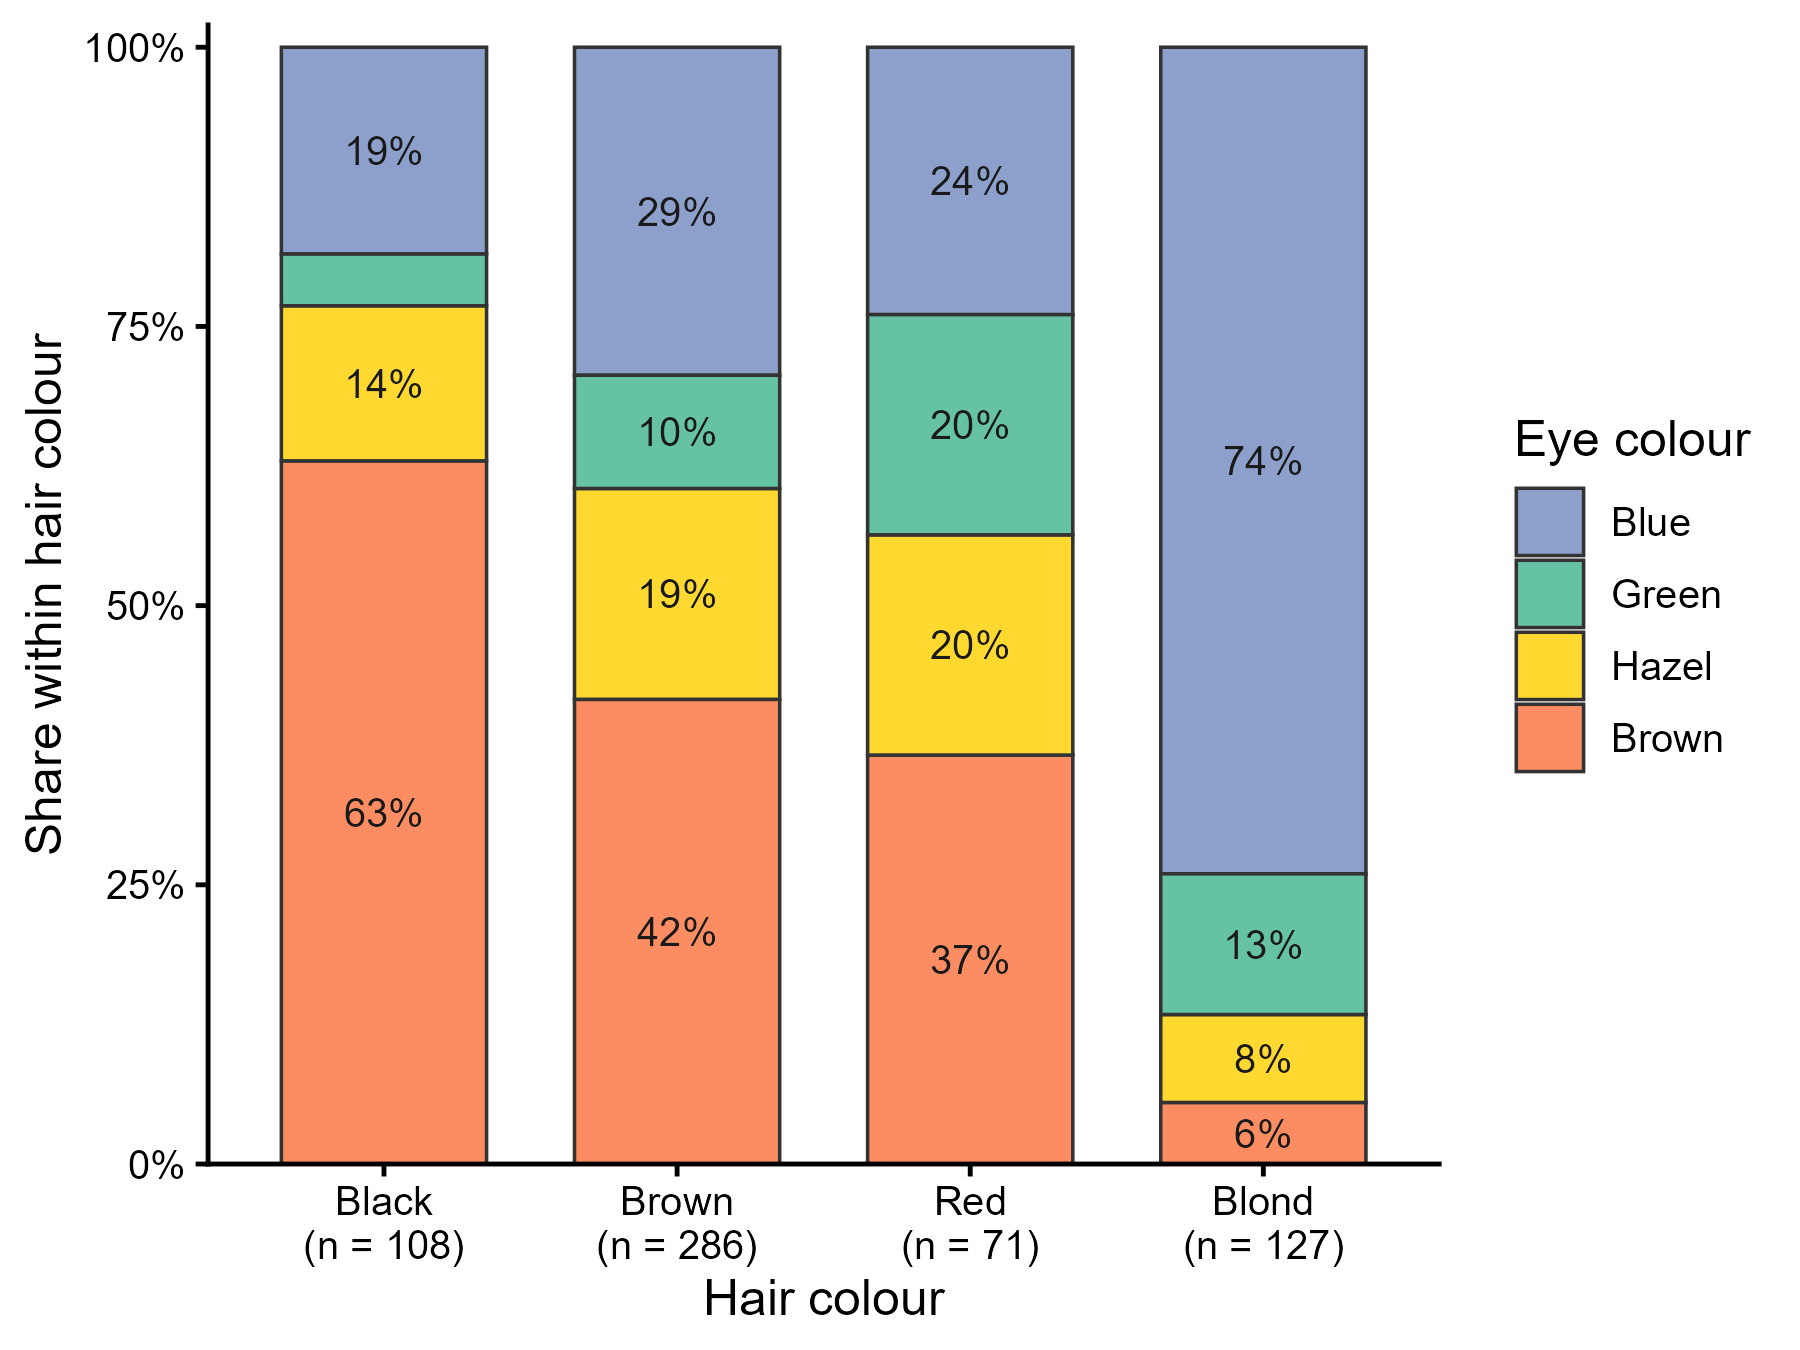
每根柱代表一个组,柱内按类别堆叠并换算成该组内的百分比,使每根柱合计 100%,用来比较不同组的内部构成。
图与代码
code/R/main.R
suppressPackageStartupMessages({
  library(ggplot2)
  library(dplyr)
})

d <- read.csv("data/hair_eye.csv", encoding = "UTF-8")
hair_lv <- c("Black", "Brown", "Red", "Blond")      # 柱的顺序固定
eye_lv <- c("Blue", "Green", "Hazel", "Brown")      # 因子水平顺序 = 图例与堆叠从上到下的顺序(Brown 在最底层)
d$hair <- factor(d$hair, levels = hair_lv)
d$eye <- factor(d$eye, levels = eye_lv)

# 每个发色内部的百分比 = 该格人数 / 该发色总人数 × 100,每柱合计 100%
d <- d %>%
  group_by(hair) %>%
  mutate(n_hair = sum(count), pct = count / n_hair * 100) %>%
  ungroup()
st <- d %>% arrange(hair, eye) %>%
  transmute(item = paste0(hair, "_", eye), value = sprintf("%.4f", pct))
st <- rbind(st, data.frame(item = paste0(hair_lv, "_n"), value = as.character(d$n_hair[match(hair_lv, d$hair)])))
write.csv(st, "outputs/stats_r.csv", row.names = FALSE, quote = FALSE)

xl <- setNames(paste0(hair_lv, "\n(n = ", d$n_hair[match(hair_lv, d$hair)], ")"), hair_lv)
d$lab <- ifelse(d$pct >= 5, sprintf("%.0f%%", d$pct), "")     # 小于 5% 的段不标

p <- ggplot(d, aes(x = hair, y = pct, fill = eye)) +
  geom_col(width = 0.7, colour = "grey20", linewidth = 0.4) +
  geom_text(aes(label = lab), position = position_stack(vjust = 0.5), size = 3.4, colour = "grey10") +
  scale_fill_manual(values = c(Brown = "#FC8D62", Hazel = "#FFD92F", Green = "#66C2A5", Blue = "#8DA0CB")) +
  scale_x_discrete(labels = xl) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.02)), breaks = seq(0, 100, 25), labels = function(v) paste0(v, "%")) +
  labs(x = "Hair colour", y = "Share within hair colour", fill = "Eye colour") +
  theme_classic(base_size = 12)

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")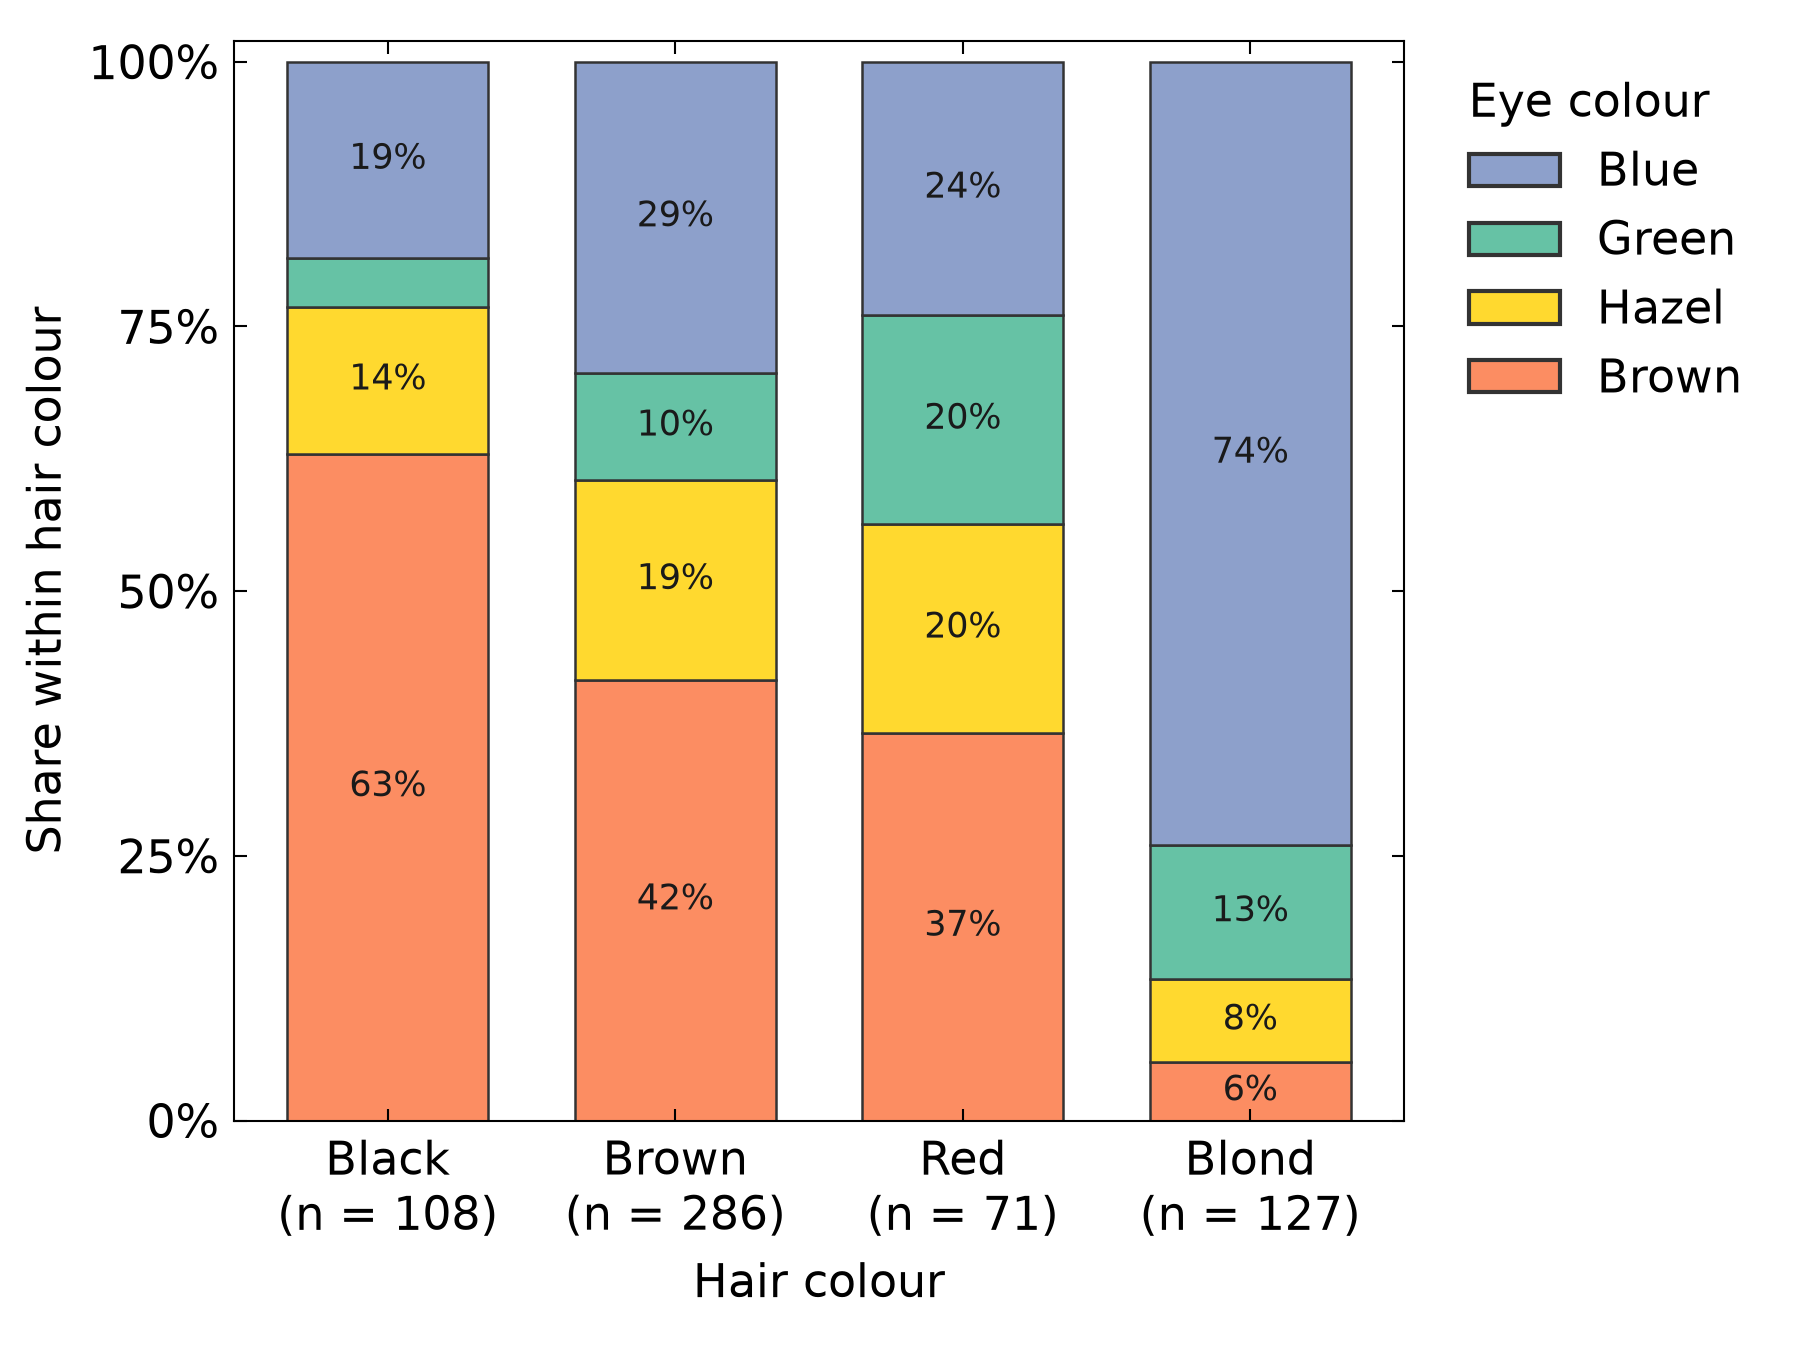
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots  # noqa: F401
from matplotlib.patches import Patch

plt.style.use(["science", "no-latex"])
plt.rcParams.update({"font.family": "sans-serif", "font.size": 11})  # 与 R 版(theme_classic 无衬线)统一
plt.rcParams["savefig.bbox"] = "standard"                            # scienceplots 默认裁白边,这里保持 6×4.5 in 画布

d = pd.read_csv("data/hair_eye.csv")
hair_lv = ["Black", "Brown", "Red", "Blond"]       # 柱的顺序固定
eye_stack = ["Brown", "Hazel", "Green", "Blue"]    # 自下而上的堆叠顺序(与 R 版图例从上到下 Blue→Brown 对应)
colors = {"Brown": "#FC8D62", "Hazel": "#FFD92F", "Green": "#66C2A5", "Blue": "#8DA0CB"}

# 每个发色内部的百分比 = 该格人数 / 该发色总人数 × 100,每柱合计 100%
tab = d.pivot(index="hair", columns="eye", values="count").loc[hair_lv, eye_stack]
n_hair = tab.sum(axis=1)
pct = tab.div(n_hair, axis=0) * 100

rows = [(f"{h}_{e}", f"{pct.loc[h, e]:.4f}") for h in hair_lv for e in ["Blue", "Green", "Hazel", "Brown"]]
rows += [(f"{h}_n", str(int(n_hair[h]))) for h in hair_lv]
pd.DataFrame(rows, columns=["item", "value"]).to_csv("outputs/stats_py.csv", index=False)

fig, ax = plt.subplots(figsize=(6, 4.5))
x = np.arange(len(hair_lv))
bottom = np.zeros(len(hair_lv))
for e in eye_stack:
    h = pct[e].to_numpy()
    ax.bar(x, h, bottom=bottom, width=0.7, color=colors[e], edgecolor="#333333", linewidth=0.6)
    for xi, hi, bi in zip(x, h, bottom):
        if hi >= 5:                                  # 小于 5% 的段不标
            ax.text(xi, bi + hi / 2, f"{hi:.0f}%", ha="center", va="center", fontsize=8.5, color="#1A1A1A")
    bottom += h

ax.set_xticks(x)
ax.set_xticklabels([f"{h}\n(n = {int(n_hair[h])})" for h in hair_lv])
ax.set_yticks(range(0, 101, 25))
ax.set_yticklabels([f"{v}%" for v in range(0, 101, 25)])
ax.set_ylim(0, 102)
ax.set_xlabel("Hair colour")
ax.set_ylabel("Share within hair colour")
ax.tick_params(axis="x", which="minor", bottom=False, top=False)
ax.minorticks_off()
ax.legend(handles=[Patch(facecolor=colors[e], edgecolor="#333333", label=e) for e in ["Blue", "Green", "Hazel", "Brown"]],
          title="Eye colour", loc="upper left", bbox_to_anchor=(1.02, 1.0), frameon=False, alignment="left")
fig.subplots_adjust(left=0.13, right=0.78, bottom=0.17, top=0.97)
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 比较几个组的内部构成(比例),而不关心各组绝对人数
- 各组样本量差异很大,直接堆叠人数不便比较时
- 类别个数不多(一般不超过 4~5 类)
常见误用
- 堆叠柱只有最底层(共同基线)和整根柱的总量容易比较;中间层的起点不一致,跨柱比较其高低很困难,必要时直接看标注的百分比或改用并列柱、分面
- 换算成百分比后各组人数的信息消失,必须把各组样本量标在图上(本例写在横轴标签的 n 里);小样本组的百分比波动大
- 类别的堆叠顺序和颜色会影响阅读,应固定顺序且让颜色能区分;过小的段(本例小于 5%)不标数字以免拥挤,但数值仍在 outputs/stats_*.csv 中
- 本例的发色与眼色是同一批学生的观察数据,百分比描述的是样本构成,不能直接推断为更大人群的比例,也不说明因果
数据与下载
数据:R 内置数据集 HairEyeColor(datasets 包)(R 内置数据集(随 R 分发,GPL-2 | GPL-3))。592 名统计学课程学生的发色(Black、Brown、Red、Blond)、眼色(Brown、Blue、Hazel、Green)和性别的列联表。本例把男、女两个性别的人数相加(按性别合并),再在每个发色内部计算各眼色所占百分比(该格人数 / 该发色总人数 × 100)。堆叠自下而上为 Brown、Hazel、Green、Blue,发色顺序固定为 Black、Brown、Red、Blond。
下载包 sha256:4203fbdf61445ad66a4cf2e1ba48c967b15a554f039f6d516078a95f7dde60d2