主成分分析(PCA)样本图
GAL-0015
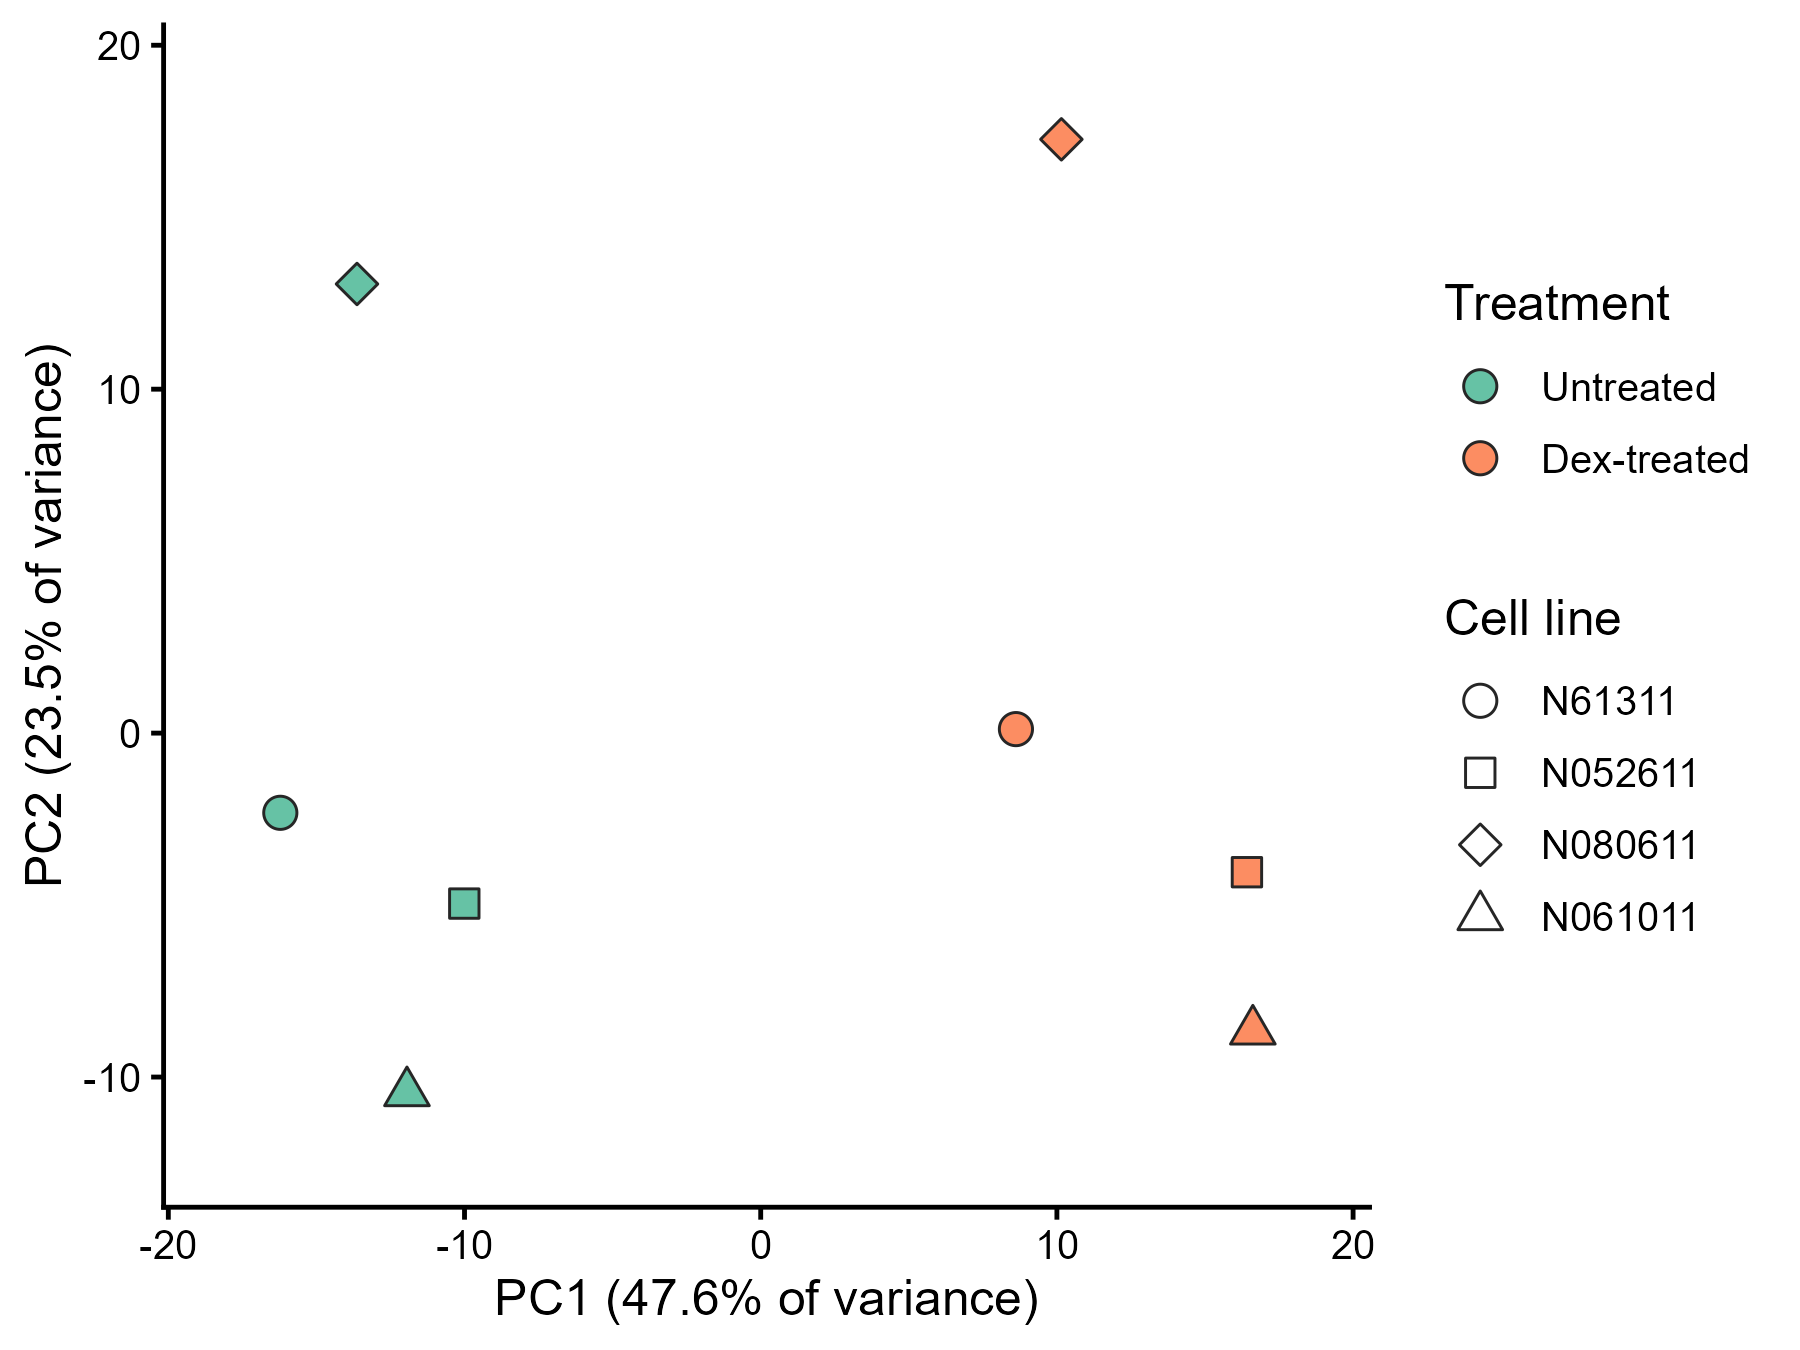
把样本在高变基因表达空间中的整体差异压缩到前两个主成分上,用颜色和形状分别标出处理与细胞系,检查样本分组、批次效应和离群样本。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))

vst <- read.csv("data/vst_all.csv", encoding = "UTF-8", check.names = FALSE)
sm <- read.csv("data/samples.csv", encoding = "UTF-8")
m <- as.matrix(vst[, sm$sample]); rownames(m) <- vst$gene_id

# vst 后方差最大的 500 个基因(方差用 n-1;同值按 gene_id)
v <- apply(m, 1, var)
sel <- head(order(-v, rownames(m), method = "radix"), 500)
pc <- prcomp(t(m[sel, ]), center = TRUE, scale. = FALSE)     # 只中心化,不缩放(vst 值已是方差稳定尺度)
sc <- pc$x
flip <- ifelse(sc[1, ] > 0, -1, 1)                           # 符号任意,约定:第 1 个样本在每个 PC 上的得分为负
sc <- sweep(sc, 2, flip, `*`)
ve <- pc$sdev^2 / sum(pc$sdev^2) * 100

st <- data.frame(item = c(paste0("PC", 1:4, "_var_pct"), paste0(sm$sample, "_PC1"), paste0(sm$sample, "_PC2")),
                 value = c(sprintf("%.4f", ve[1:4]), sprintf("%.4f", sc[, 1]), sprintf("%.4f", sc[, 2])))
write.csv(st, "outputs/stats_r.csv", row.names = FALSE, quote = FALSE)

d <- data.frame(PC1 = sc[, 1], PC2 = sc[, 2], dex = factor(sm$dex, levels = c("untrt", "trt")),
                cell = factor(sm$cell, levels = unique(sm$cell)))
p <- ggplot(d, aes(PC1, PC2, fill = dex, shape = cell)) +
  geom_point(size = 3.4, colour = "grey15", stroke = 0.5) +
  scale_fill_manual(values = c(untrt = "#66C2A5", trt = "#FC8D62"), labels = c("Untreated", "Dex-treated"),
                    guide = guide_legend(order = 1, override.aes = list(shape = 21, size = 3.4))) +
  scale_shape_manual(values = c(21, 22, 23, 24), guide = guide_legend(order = 2)) +
  scale_x_continuous(expand = expansion(mult = 0.12)) + scale_y_continuous(expand = expansion(mult = 0.12)) +
  labs(x = sprintf("PC1 (%.1f%% of variance)", ve[1]), y = sprintf("PC2 (%.1f%% of variance)", ve[2]),
       fill = "Treatment", shape = "Cell line") +
  theme_classic(base_size = 12)

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")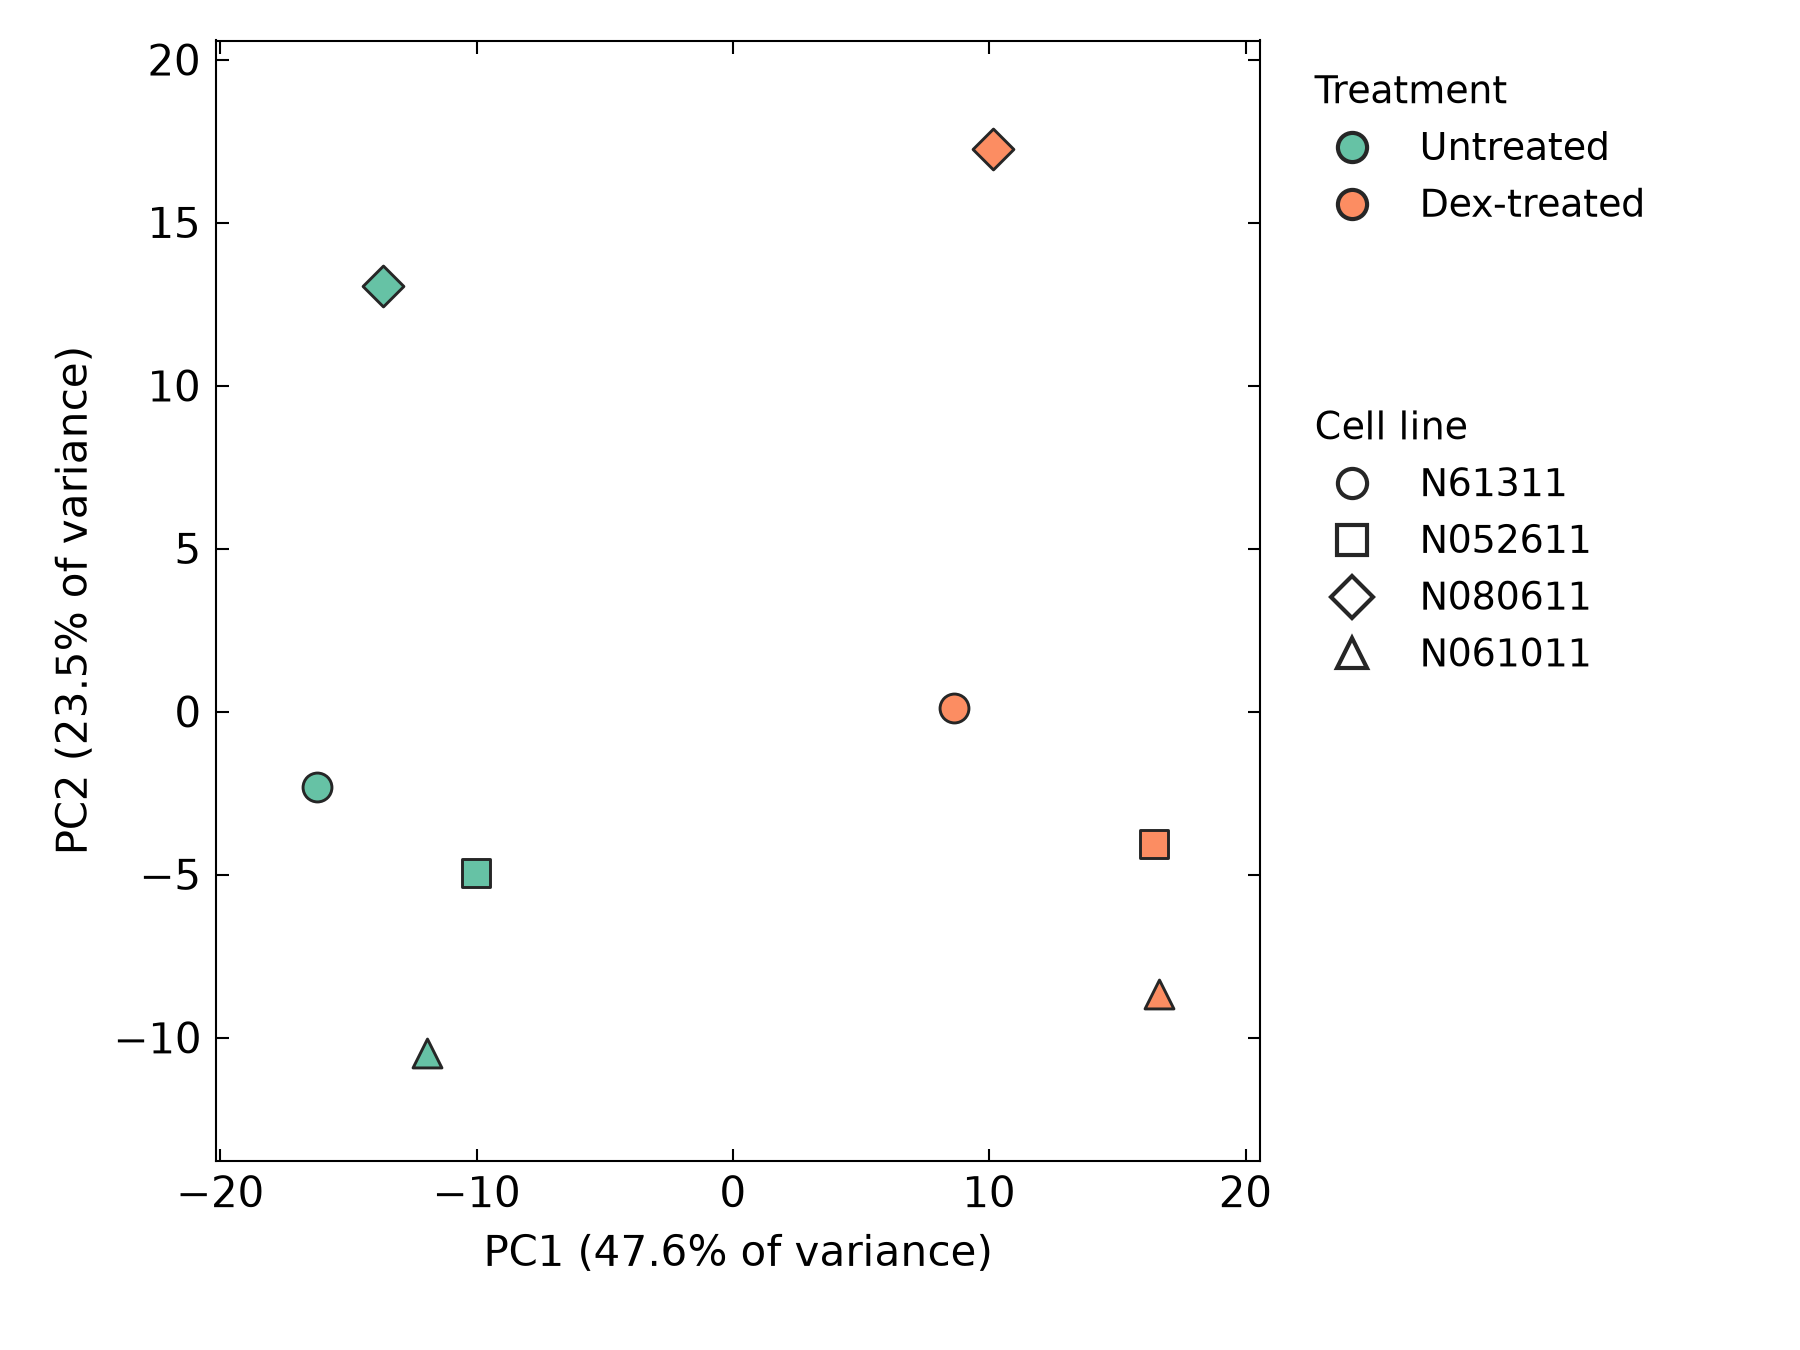
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D
import scienceplots  # noqa: F401

plt.style.use(["science", "no-latex"])
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["savefig.bbox"] = "standard"                      # scienceplots 默认裁白边,这里保持 6×4.5 in 画布

vst = pd.read_csv("data/vst_all.csv").set_index("gene_id")
sm = pd.read_csv("data/samples.csv")
m = vst[sm["sample"]]

# vst 后方差最大的 500 个基因(方差用 n-1;同值按 gene_id)
v = m.var(axis=1, ddof=1)
sel = pd.DataFrame({"v": -v, "g": m.index}).sort_values(["v", "g"]).head(500)["g"]
x = m.loc[sel].to_numpy().T                                   # 样本 × 基因
x = x - x.mean(axis=0)                                        # 只中心化,不缩放
u, s, vt = np.linalg.svd(x, full_matrices=False)
sc = u * s
sc = sc * np.where(sc[0] > 0, -1.0, 1.0)                      # 符号任意,约定:第 1 个样本在每个 PC 上的得分为负
ve = s ** 2 / np.sum(s ** 2) * 100

st = pd.DataFrame({"item": [f"PC{i}_var_pct" for i in range(1, 5)] + [f"{k}_PC1" for k in sm["sample"]] + [f"{k}_PC2" for k in sm["sample"]],
                   "value": [f"{t:.4f}" for t in ve[:4]] + [f"{t:.4f}" for t in sc[:, 0]] + [f"{t:.4f}" for t in sc[:, 1]]})
st.to_csv("outputs/stats_py.csv", index=False)

dex_col = {"untrt": "#66C2A5", "trt": "#FC8D62"}
cells = list(dict.fromkeys(sm["cell"]))
mk = dict(zip(cells, ["o", "s", "D", "^"]))
fig, ax = plt.subplots(figsize=(6, 4.5))
for i, r in sm.iterrows():
    ax.scatter(sc[i, 0], sc[i, 1], s=48, marker=mk[r.cell], c=dex_col[r.dex], edgecolors="#262626", linewidths=0.7, zorder=3)
ax.margins(0.12)
ax.set_xlabel(f"PC1 ({ve[0]:.1f}% of variance)")
ax.set_ylabel(f"PC2 ({ve[1]:.1f}% of variance)")
ax.tick_params(which="minor", length=0)
h1 = [Line2D([], [], marker="o", ls="", ms=7, mfc=dex_col[k], mec="#262626", label=l)
      for k, l in [("untrt", "Untreated"), ("trt", "Dex-treated")]]
h2 = [Line2D([], [], marker=mk[c], ls="", ms=7, mfc="white", mec="#262626", label=c) for c in cells]
l1 = ax.legend(handles=h1, title="Treatment", loc="upper left", bbox_to_anchor=(1.02, 1.0), frameon=False, alignment="left", fontsize=9, title_fontsize=9)
ax.add_artist(l1)
ax.legend(handles=h2, title="Cell line", loc="upper left", bbox_to_anchor=(1.02, 0.7), frameon=False, alignment="left", fontsize=9, title_fontsize=9)

fig.subplots_adjust(left=0.12, right=0.70, bottom=0.14, top=0.97)
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 差异分析前做质量检查:重复是否聚在一起,主要变异来自处理还是批次
- 发现离群样本或样本标签错误
- 说明设计中需要作为协变量处理的批次因素
常见误用
- PCA 是无监督的描述方法,不做假设检验;主成分与处理的关系只能说明变异的主要来源,不是效应显著的证据
- 方差解释比例只对所选基因和样本而言;本例仅 8 个样本,主成分得分和比例的稳定性有限
- 主成分的正负号是任意的(本例约定第 1 个样本得分为负),图的左右或上下翻转不改变含义
- 基因选择(本例 vst 后方差最大的 500 个基因)、是否缩放都会改变结果;本例 vst 用 blind = FALSE(利用设计公式估计离散度趋势),做纯质量检查时常用 blind = TRUE
数据与下载
数据:R/Bioconductor 数据包 airway(人气道平滑肌细胞,地塞米松处理 vs 未处理,4 个细胞系各 1 对,共 8 个样本)(airway 数据包(Bioconductor,LGPL);原始数据来自 GEO GSE52778,原文 Himes et al. 2014(PLoS ONE,CC BY);基因注释来自 org.Hs.eg.db(Artistic-2.0))。DESeq2 的 vst 矩阵(删除全零基因后 33,469 个基因,blind = FALSE),取 vst 后方差(n−1)最大的 500 个基因,只中心化不缩放,对样本做 PCA;PC1 解释 47.6%、PC2 解释 23.5% 的方差。PC1 与处理(dex)对应,PC2 与细胞系对应。R 用 prcomp,Python 用 numpy SVD,两版得分在 4 位小数内一致(outputs/stats_*.csv)。
下载包 sha256:5e15663bca2d5f3f8543c4309532710be3aff1c2dee6a91031c4536e906d3023