火山图(差异表达基因)
GAL-0012
把每个基因的效应大小(log2 倍数变化)和统计显著性(−log10 校正后 P 值)画在同一张图上,一眼看出哪些基因变化既大又显著,并标出最显著的几个基因。
图与代码
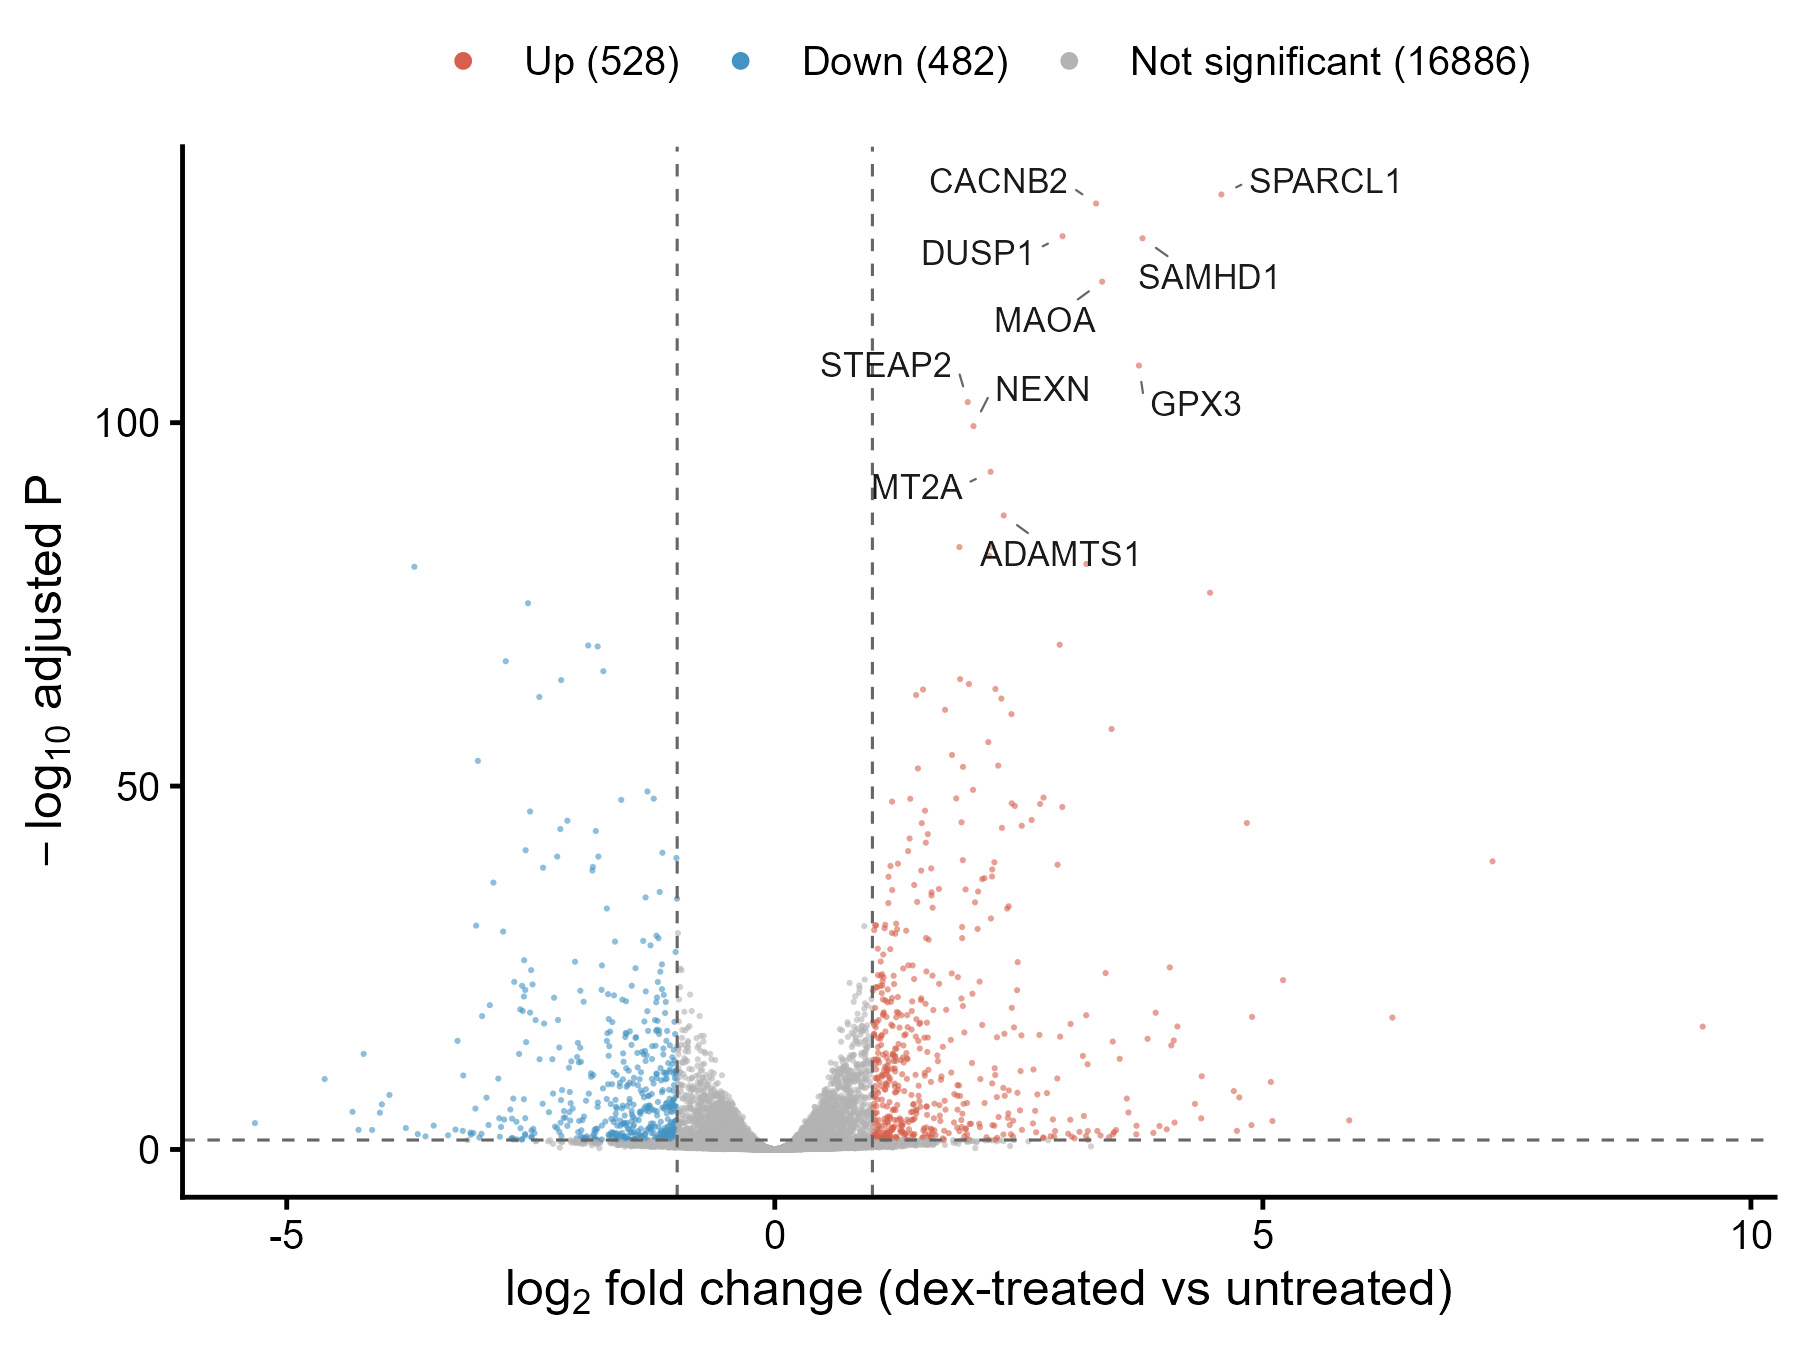
code/R/main.R
suppressPackageStartupMessages({ library(ggplot2); library(ggrepel) })

d <- read.csv("data/deseq_results.csv", encoding = "UTF-8")
d <- d[!is.na(d$padj), ]                                   # padj 为 NA(独立过滤或离群值)的基因不画
d$nlp <- -log10(d$padj)
d$status <- ifelse(d$sig_deg & d$log2FoldChange > 0, "Up",
            ifelse(d$sig_deg & d$log2FoldChange < 0, "Down", "Not significant"))
d$status <- factor(d$status, levels = c("Up", "Down", "Not significant"))

# 标注 padj 最小的 10 个显著基因(同值按 gene_id 排序)
lab <- d[d$sig_deg, ]
lab <- head(lab[order(lab$padj, lab$gene_id, method = "radix"), ], 10)

cnt <- table(d$status)
st <- data.frame(item = c("n_up", "n_down", "n_not_significant", paste0("label_", 1:10)),
                 value = c(as.integer(cnt[c("Up", "Down", "Not significant")]), lab$symbol))
write.csv(st, "outputs/stats_r.csv", row.names = FALSE, quote = FALSE)

p <- ggplot(d, aes(log2FoldChange, nlp, colour = status)) +
  geom_point(size = 0.7, alpha = 0.6, stroke = 0) +
  geom_vline(xintercept = c(-1, 1), linetype = "dashed", linewidth = 0.35, colour = "grey40") +
  geom_hline(yintercept = -log10(0.05), linetype = "dashed", linewidth = 0.35, colour = "grey40") +
  geom_text_repel(data = lab, aes(label = symbol), colour = "grey10", size = 2.9, seed = 42,
                  min.segment.length = 0, segment.size = 0.25, segment.colour = "grey40",
                  box.padding = 0.35, point.padding = 0.2, max.overlaps = Inf) +
  scale_colour_manual(values = c(Up = "#D6604D", Down = "#4393C3", "Not significant" = "grey70"),
                      labels = c(paste0("Up (", cnt[["Up"]], ")"), paste0("Down (", cnt[["Down"]], ")"),
                                 paste0("Not significant (", cnt[["Not significant"]], ")"))) +
  guides(colour = guide_legend(override.aes = list(size = 2, alpha = 1))) +
  labs(x = expression(log[2]~"fold change (dex-treated vs untreated)"), y = expression(-log[10]~"adjusted P"), colour = NULL) +
  theme_classic(base_size = 12) +
  theme(legend.position = "top", legend.margin = margin(0, 0, 0, 0))

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")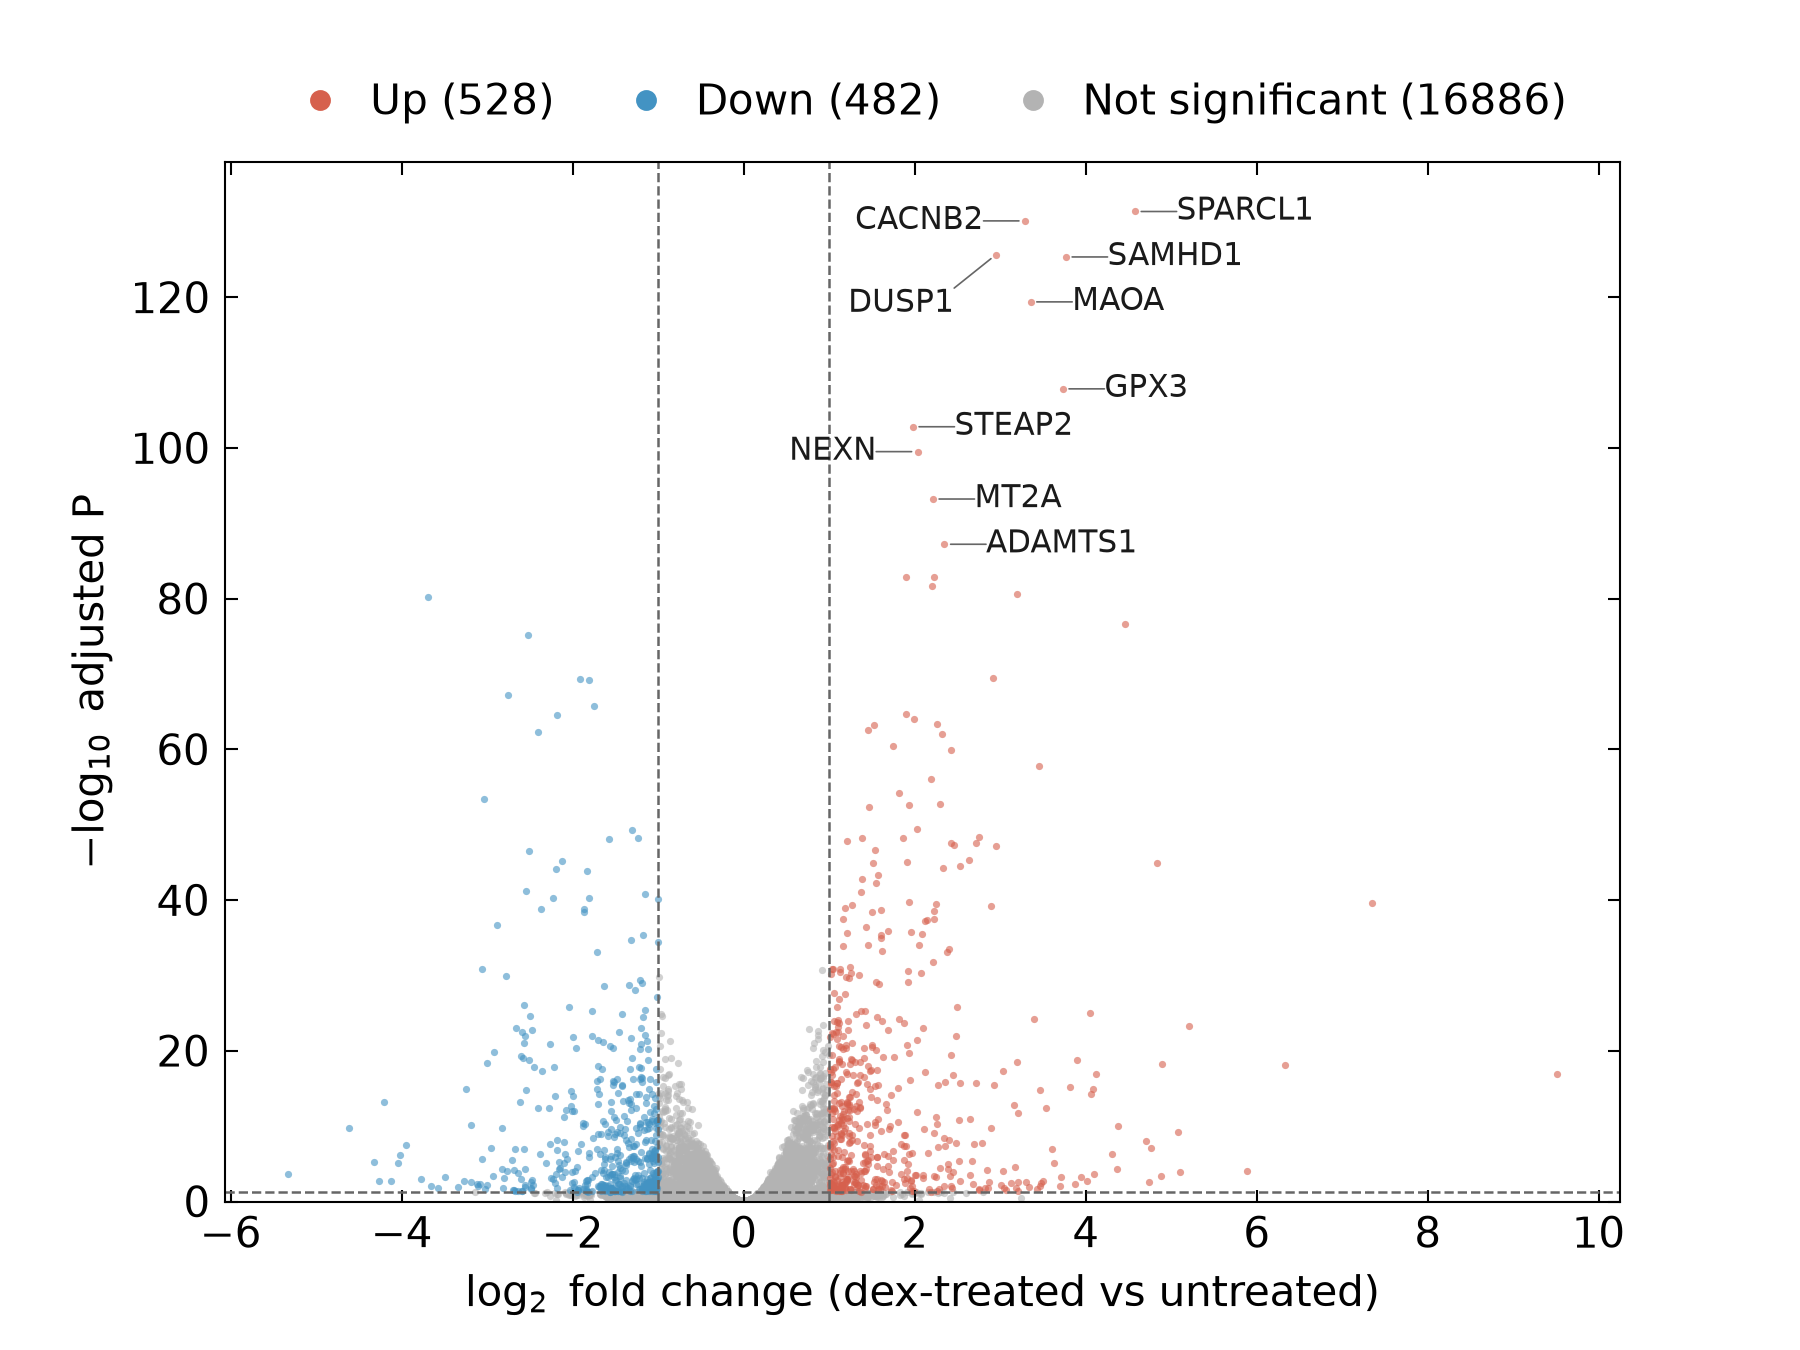
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D
import scienceplots  # noqa: F401

plt.style.use(["science", "no-latex"])
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["savefig.bbox"] = "standard"                      # scienceplots 默认裁白边,这里保持 6×4.5 in 画布
plt.rcParams["mathtext.fontset"] = "dejavusans"

d = pd.read_csv("data/deseq_results.csv")
d = d[d["padj"].notna()].copy()                              # padj 为 NA(独立过滤或离群值)的基因不画
d["nlp"] = -np.log10(d["padj"])
d["status"] = np.where(d.sig_deg & (d.log2FoldChange > 0), "Up",
                       np.where(d.sig_deg & (d.log2FoldChange < 0), "Down", "Not significant"))

# 标注 padj 最小的 10 个显著基因(同值按 gene_id 排序)
lab = d[d.sig_deg].sort_values(["padj", "gene_id"]).head(10)

cnt = d["status"].value_counts()
st = pd.DataFrame({"item": ["n_up", "n_down", "n_not_significant"] + [f"label_{i}" for i in range(1, 11)],
                   "value": [cnt["Up"], cnt["Down"], cnt["Not significant"]] + list(lab.symbol)})
st.to_csv("outputs/stats_py.csv", index=False)

cols = {"Up": "#D6604D", "Down": "#4393C3", "Not significant": "#B3B3B3"}
fig, ax = plt.subplots(figsize=(6, 4.5))
for s in ["Not significant", "Down", "Up"]:
    x = d[d.status == s]
    ax.scatter(x.log2FoldChange, x.nlp, s=3, c=cols[s], alpha=0.6, linewidths=0, rasterized=False)
for v in (-1, 1):
    ax.axvline(v, ls="--", lw=0.6, c="#666666")
ax.axhline(-np.log10(0.05), ls="--", lw=0.6, c="#666666")
ax.set_xlabel(r"$\log_2$ fold change (dex-treated vs untreated)")
ax.set_ylabel(r"$-\log_{10}$ adjusted P")
ax.tick_params(which="minor", length=0)
ax.set_ylim(bottom=0)
handles = [Line2D([], [], marker="o", ls="", ms=4, c=cols[s], label=f"{s} ({cnt[s]})") for s in ["Up", "Down", "Not significant"]]
ax.legend(handles=handles, loc="lower center", bbox_to_anchor=(0.5, 1.0), ncol=3, frameon=False,
          handletextpad=0.2, columnspacing=1.2)

# 手工错位放置标签(不依赖 adjustText):按 padj 顺序,依次试探半径递增的 8 个方向,
# 取第一个与已放标签、所有标注点、坐标轴边界都不重叠的位置;偏移较大时画细引线
fig.canvas.draw()
rend = fig.canvas.get_renderer()
pts = ax.transData.transform(np.c_[lab.log2FoldChange, lab.nlp])
occupied = [(x - 4, y - 4, x + 4, y + 4) for x, y in pts]          # 点周围的保留区(像素)
axbox = ax.get_window_extent(rend)
sc = fig.dpi / 72.0
dirs = [(1, 0), (-1, 0), (0, 1), (0, -1), (1, 1), (-1, 1), (1, -1), (-1, -1)]
hit = lambda a, b: not (a[2] < b[0] or b[2] < a[0] or a[3] < b[1] or b[3] < a[1])
for (_, r), (px, py) in zip(lab.iterrows(), pts):
    done = False
    for rad in (4, 10, 18, 28, 40, 54):
        for ux, uy in dirs:
            dx, dy = ux * rad, uy * rad * 0.8
            ha = "left" if ux > 0 else ("right" if ux < 0 else "center")
            va = "bottom" if uy > 0 else ("top" if uy < 0 else "center")
            t = ax.annotate(r.symbol, (r.log2FoldChange, r.nlp), xytext=(dx, dy), textcoords="offset points",
                            ha=ha, va=va, fontsize=7.5, color="#1a1a1a")
            bb = t.get_window_extent(rend)
            box = (bb.x0 - 2, bb.y0 - 2, bb.x1 + 2, bb.y1 + 2)
            inside = box[0] >= axbox.x0 and box[2] <= axbox.x1 and box[1] >= axbox.y0 and box[3] <= axbox.y1
            if inside and not any(hit(box, o) for o in occupied):
                occupied.append(box)
                if rad > 4:                                              # 偏移较大时补一条细引线
                    ax.annotate("", (r.log2FoldChange, r.nlp), xytext=(dx, dy), textcoords="offset points",
                                arrowprops=dict(arrowstyle="-", lw=0.4, color="#666666", shrinkA=0, shrinkB=1.5))
                done = True
                break
            t.remove()
        if done:
            break

fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- RNA-seq 等组学差异分析之后,总览上调与下调基因的数量和分布
- 同时用效应大小阈值和显著性阈值筛选候选基因
- 在汇报或论文中突出少数最显著或最关心的基因
常见误用
- 显著不等于重要:样本数少、表达量高的基因即使变化很小也可能非常显著;阈值(本例 padj < 0.05 且 |log2FC| > 1)是人为约定,改变阈值会改变基因数量
- 纵轴是校正后的 P 值(BH 法控制错误发现率),不是原始 P 值;padj 为 NA(低表达被独立过滤,或被判为离群值)的基因不在图中,本例 33,469 个基因中仅 17,896 个有 padj
- 本例的 log2FC 没有做收缩(lfcShrink),低表达基因的 log2FC 噪声大,极端的 log2FC 值需结合表达量(见 MA 图)谨慎解读
- 标注的是 padj 最小的 10 个基因,不等于生物学上最重要的基因;本例每个细胞系只有 1 对处理/对照,共 4 对,结论是探索性的
数据与下载
数据:R/Bioconductor 数据包 airway(人气道平滑肌细胞,地塞米松处理 vs 未处理,4 个细胞系各 1 对,共 8 个样本)(airway 数据包(Bioconductor,LGPL);原始数据来自 GEO GSE52778,原文 Himes et al. 2014(PLoS ONE,CC BY);基因注释来自 org.Hs.eg.db(Artistic-2.0))。DESeq2 差异分析,设计公式 ~ cell + dex(配对的细胞系效应 + 处理效应),参考水平 untrt,results() 默认的 BH 校正,未做 LFC 收缩;删除全零基因后共 33,469 个基因。基因名为 org.Hs.eg.db 的 SYMBOL(无 SYMBOL 时用 Ensembl ID)。显著(padj < 0.05 且 |log2FC| > 1)的基因 1,010 个:上调 528、下调 482。统计只在 R 端计算一次(code/R/make_data.R),两版作图脚本读同一份结果 CSV。
下载包 sha256:6e3b5d4684c21b59eec815c9d5586a37afcfaf05b742e24557a5911dcc4f9748