Kaplan–Meier 生存曲线(两组 + 风险人数表 + log-rank 检验)
GAL-0007
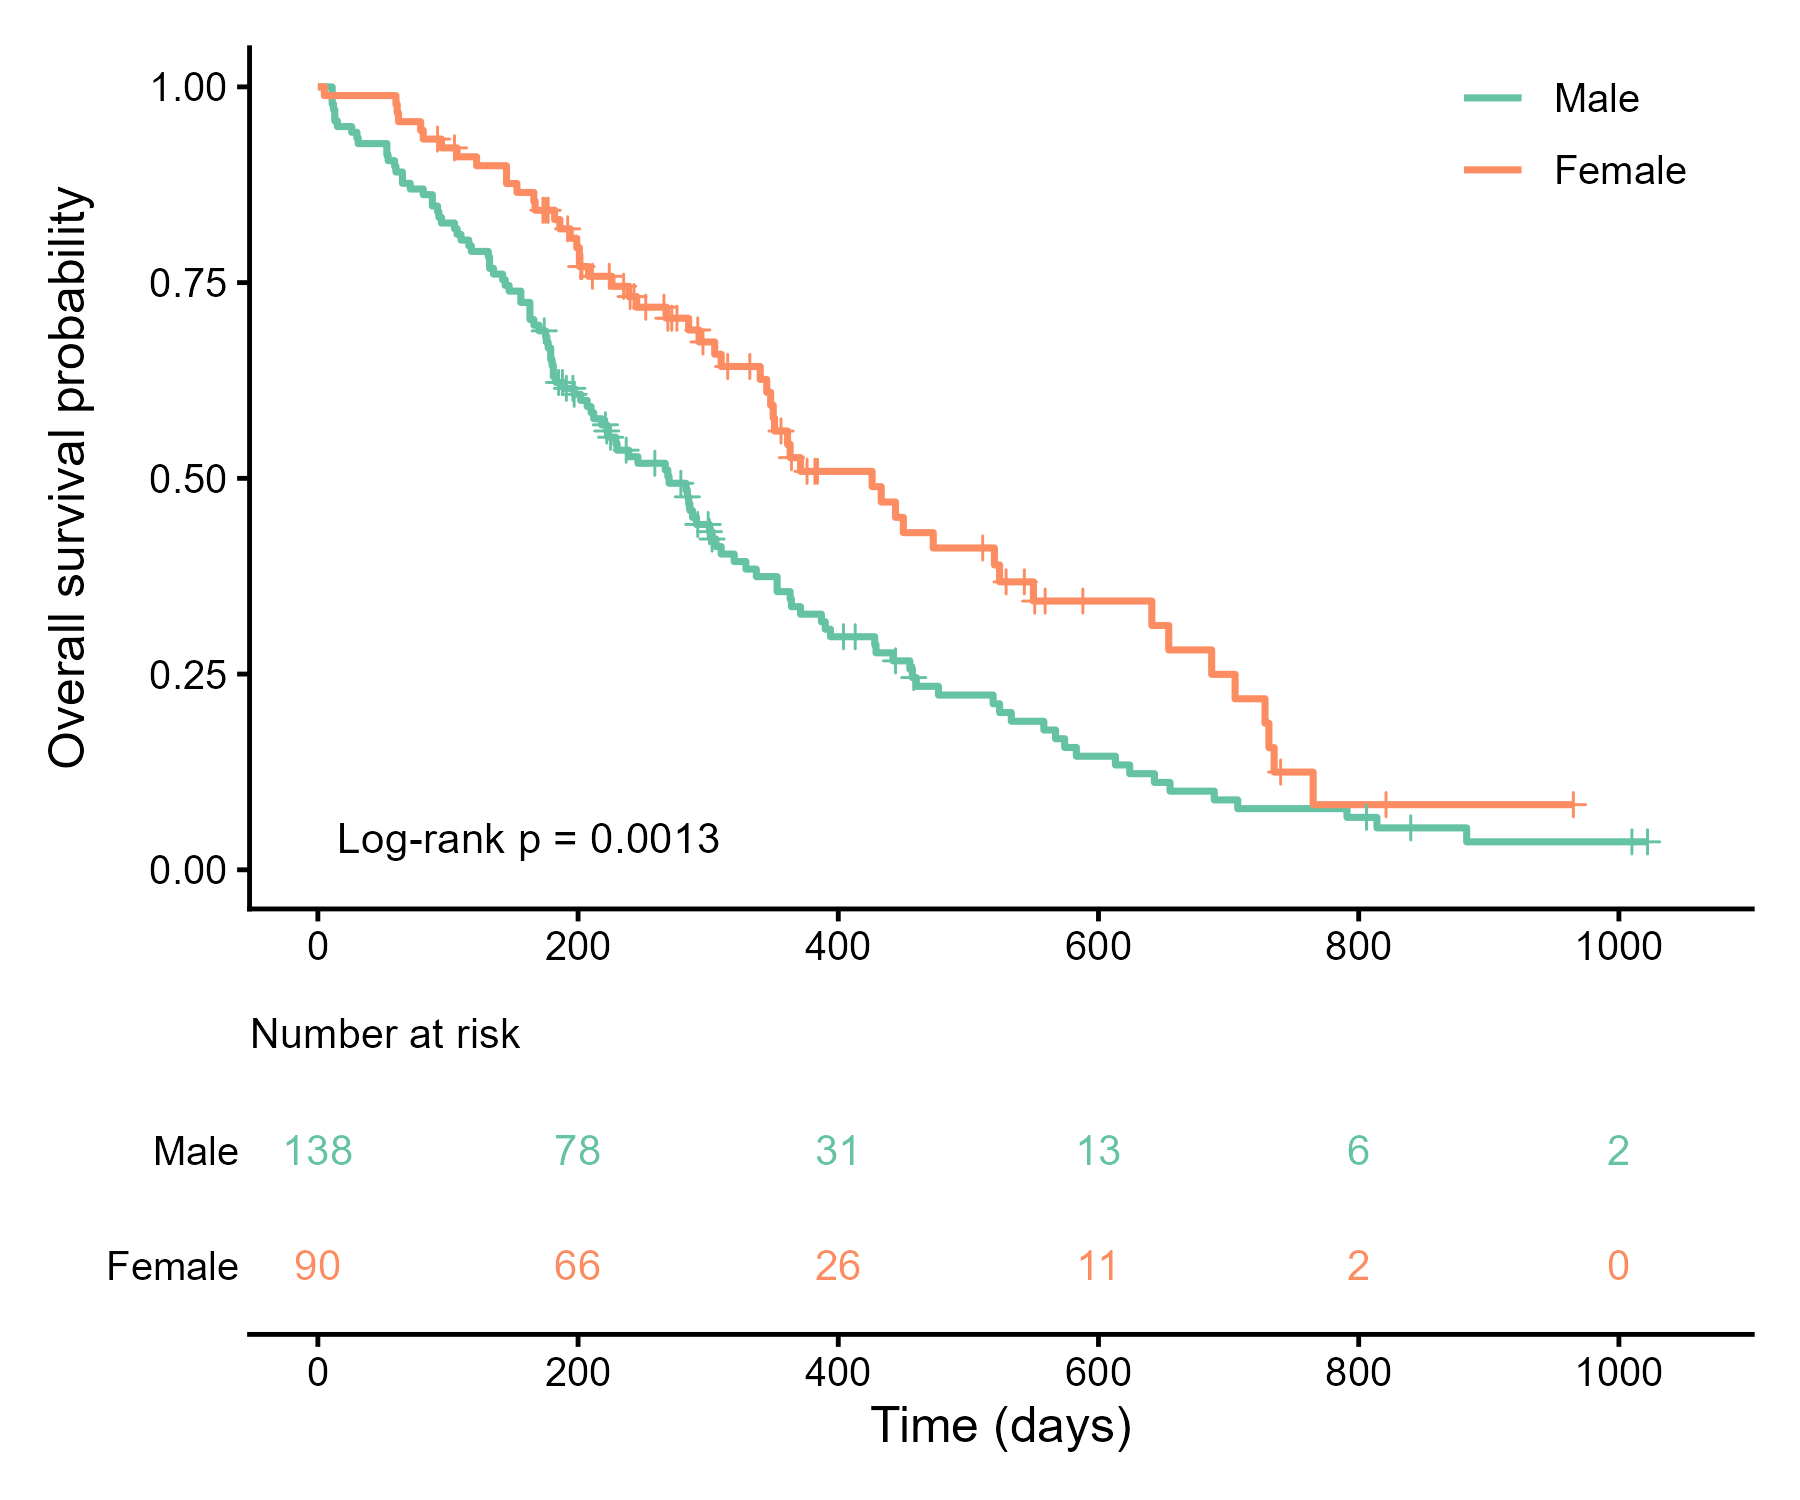
用 Kaplan–Meier 法估计两组患者的总生存概率随时间的变化,曲线下方给出各时间点的风险人数,并用 log-rank 检验比较两组生存曲线。
图与代码
code/R/main.R
suppressPackageStartupMessages({
  library(ggplot2)
  library(survival)
  library(patchwork)
})

d <- read.csv("data/lung.csv", encoding = "UTF-8")
d$event <- as.integer(d$status == 2)                      # lung:status 1 = 删失,2 = 死亡
d$grp <- factor(d$sex, levels = c(1, 2), labels = c("Male", "Female"))
cols <- c(Male = "#66C2A5", Female = "#FC8D62")
tick_times <- seq(0, 1000, by = 200)

# 每组的 Kaplan–Meier 估计、删失点处的生存概率、风险人数
curves <- list(); cens <- list(); risk <- list(); med <- c()
for (g in levels(d$grp)) {
  dg <- d[d$grp == g, ]
  s <- survfit(Surv(time, event) ~ 1, data = dg)
  curves[[g]] <- data.frame(time = c(0, s$time), surv = c(1, s$surv), grp = g)
  ct <- sort(unique(dg$time[dg$event == 0]))
  cens[[g]] <- data.frame(time = ct, surv = summary(s, times = ct, extend = TRUE)$surv, grp = g)
  risk[[g]] <- data.frame(time = tick_times, n = sapply(tick_times, function(t) sum(dg$time >= t)), grp = g)
  med[g] <- unname(summary(s)$table["median"])
}
curves <- do.call(rbind, curves); cens <- do.call(rbind, cens); risk <- do.call(rbind, risk)
curves$grp <- factor(curves$grp, levels = levels(d$grp)); cens$grp <- factor(cens$grp, levels = levels(d$grp))
risk$grp <- factor(risk$grp, levels = levels(d$grp))

lr <- survdiff(Surv(time, event) ~ grp, data = d)
lr_p <- pchisq(lr$chisq, df = 1, lower.tail = FALSE)
# p 值显示:< 0.001 写“< 0.001”;0.001~0.01 保留 2 位有效数字(如 0.0013);其余 3 位小数
fmt_p <- function(p) if (p < 0.001) "< 0.001" else if (p < 0.01) sprintf("= %.4f", signif(p, 2)) else sprintf("= %.3f", p)
ptxt <- paste("Log-rank p", fmt_p(lr_p))

# 与 Python 版对照用的数值
stats <- data.frame(
  key = c("logrank_chisq", "logrank_p", "median_male", "median_female",
          paste0("n_risk_male_", tick_times), paste0("n_risk_female_", tick_times)),
  value = c(lr$chisq, lr_p, med[["Male"]], med[["Female"]],
            risk$n[risk$grp == "Male"], risk$n[risk$grp == "Female"]))
write.csv(stats, "outputs/stats_r.csv", row.names = FALSE)

xs <- scale_x_continuous(limits = c(0, 1050), breaks = tick_times)

p1 <- ggplot(curves, aes(time, surv, colour = grp)) +
  geom_step(linewidth = 0.8) +
  geom_point(data = cens, shape = 3, size = 1.6, stroke = 0.5, show.legend = FALSE) +
  annotate("text", x = 15, y = 0.04, hjust = 0, label = ptxt, size = 3.6) +
  scale_colour_manual(values = cols, name = NULL) + xs +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(x = NULL, y = "Overall survival probability") +
  theme_classic(base_size = 12) +
  theme(legend.position = "inside", legend.position.inside = c(0.88, 0.9))

p2 <- ggplot(risk, aes(time, grp, label = n, colour = grp)) +
  geom_text(size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = cols) + xs +
  scale_y_discrete(limits = rev(levels(risk$grp))) +
  labs(x = "Time (days)", y = NULL, title = "Number at risk") +
  theme_classic(base_size = 12) +
  theme(plot.title = element_text(size = 10, hjust = 0), axis.line.y = element_blank(), axis.ticks.y = element_blank())

p <- p1 / p2 + plot_layout(heights = c(3.4, 1))
ggsave("outputs/figure_r.png", p, width = 6, height = 5, dpi = 300, bg = "white")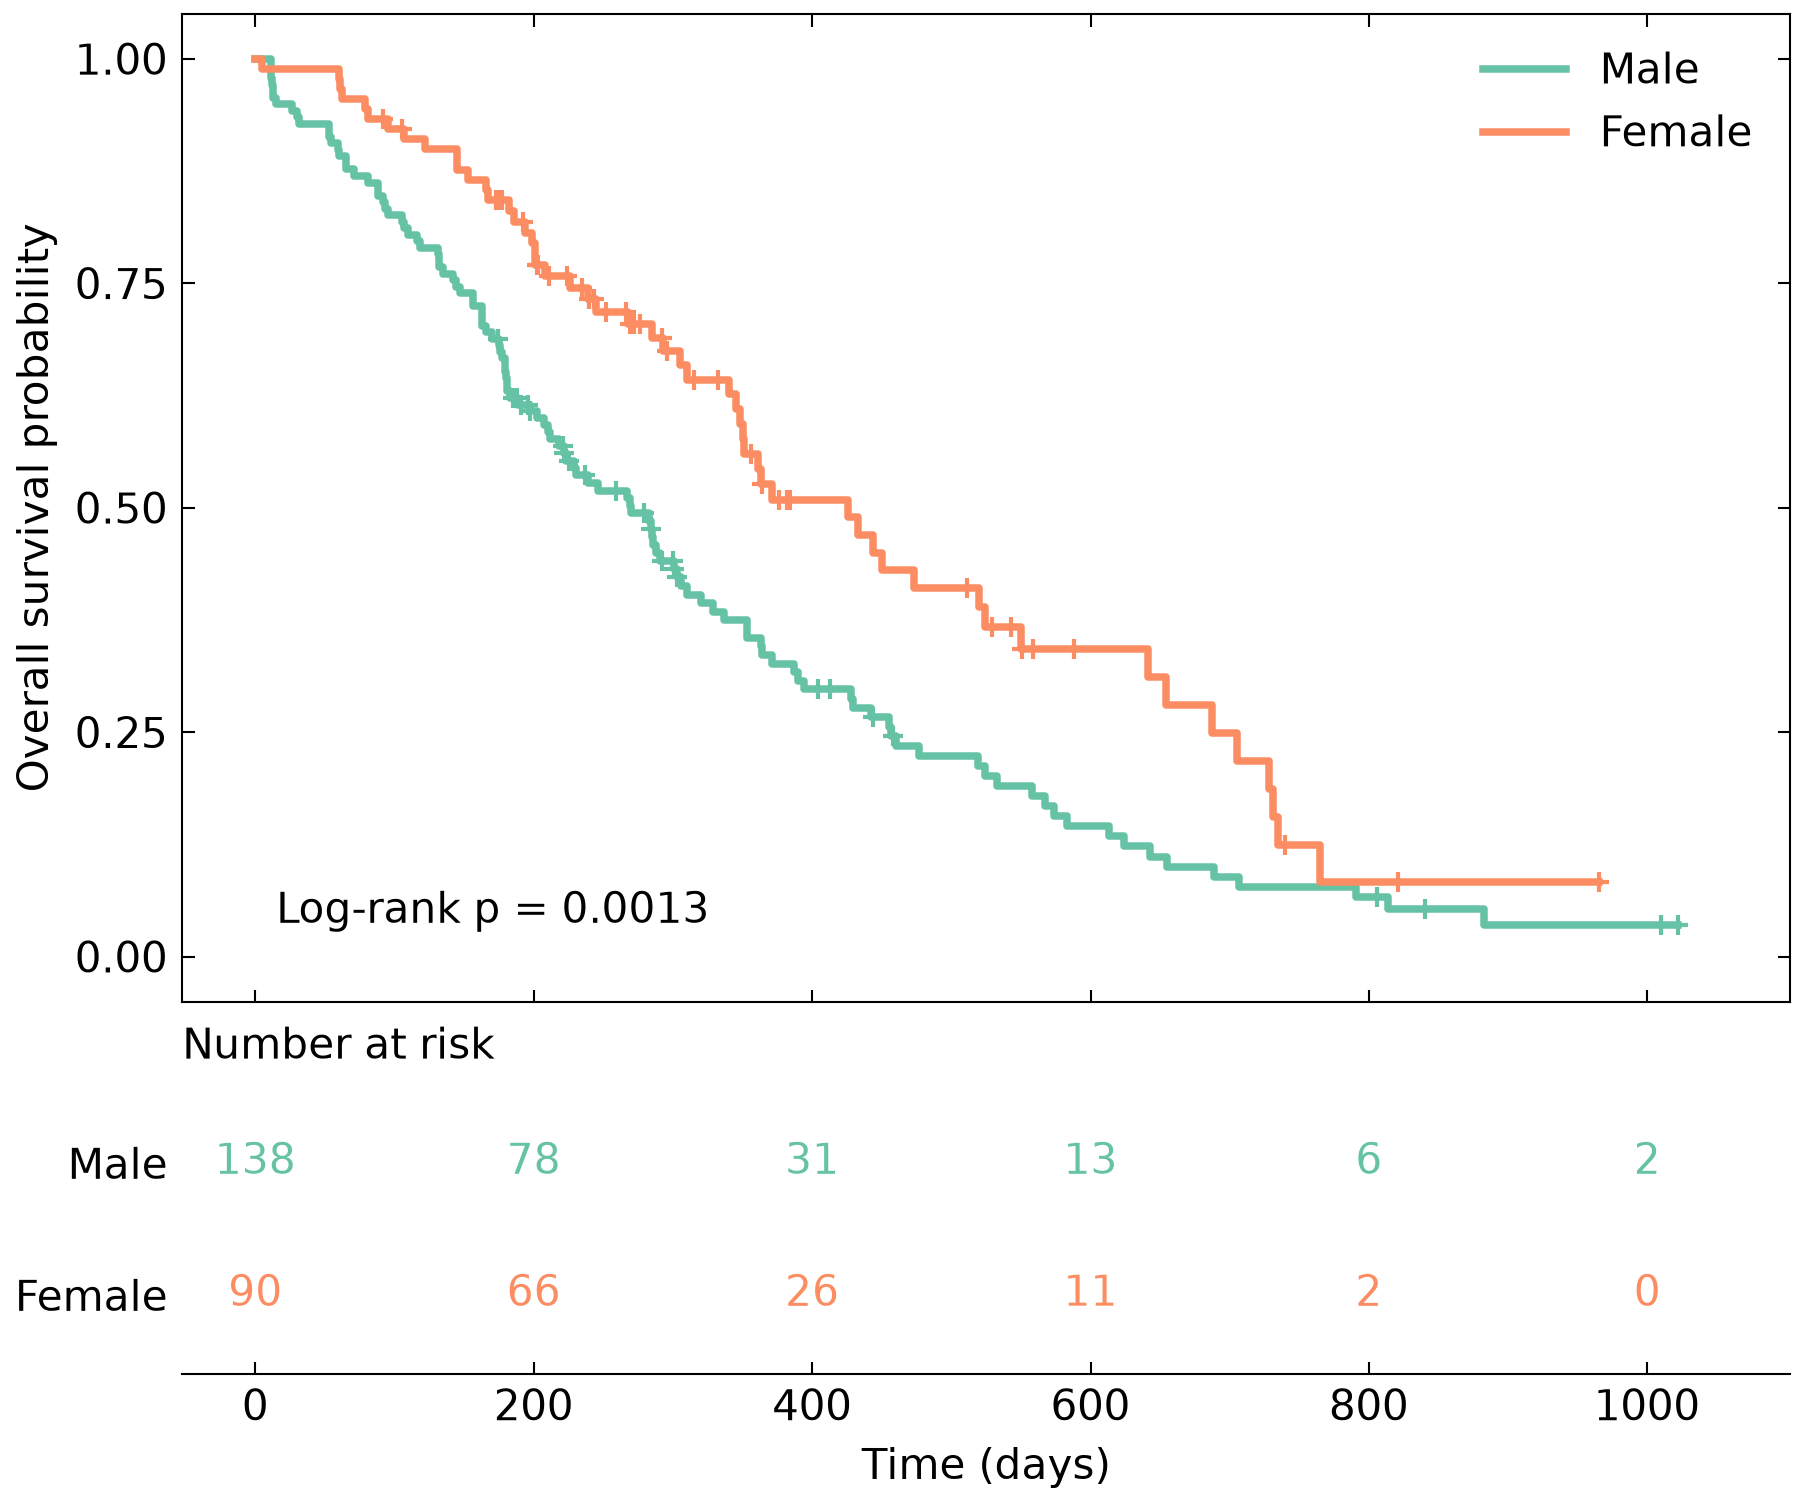
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots  # noqa: F401
from lifelines import KaplanMeierFitter
from lifelines.statistics import logrank_test

plt.style.use(["science", "no-latex"])
plt.rcParams["font.family"] = "sans-serif"

d = pd.read_csv("data/lung.csv")
d["event"] = (d["status"] == 2).astype(int)  # lung:status 1 = 删失,2 = 死亡
groups = {1: "Male", 2: "Female"}
cols = {"Male": "#66C2A5", "Female": "#FC8D62"}
tick_times = np.arange(0, 1001, 200)

fits, cens, risk = {}, {}, {}
for sex, g in groups.items():
    dg = d[d["sex"] == sex]
    kmf = KaplanMeierFitter().fit(dg["time"], dg["event"])
    fits[g] = kmf
    ct = np.sort(dg.loc[dg["event"] == 0, "time"].unique())
    cens[g] = (ct, kmf.survival_function_at_times(ct).to_numpy())
    risk[g] = [(dg["time"] >= t).sum() for t in tick_times]

a, b = d[d["sex"] == 1], d[d["sex"] == 2]
lr = logrank_test(a["time"], b["time"], a["event"], b["event"])
def fmt_p(p):
    # p 值显示:< 0.001 写“< 0.001”;0.001~0.01 保留 2 位有效数字(如 0.0013);其余 3 位小数
    if p < 0.001:
        return "< 0.001"
    return f"= {float(f'{p:.2g}'):.4f}" if p < 0.01 else f"= {p:.3f}"


ptxt = f"Log-rank p {fmt_p(lr.p_value)}"

# 与 R 版对照用的数值
rows = [("logrank_chisq", lr.test_statistic), ("logrank_p", lr.p_value),
        ("median_male", fits["Male"].median_survival_time_), ("median_female", fits["Female"].median_survival_time_)]
rows += [(f"n_risk_male_{t}", n) for t, n in zip(tick_times, risk["Male"])]
rows += [(f"n_risk_female_{t}", n) for t, n in zip(tick_times, risk["Female"])]
pd.DataFrame(rows, columns=["key", "value"]).to_csv("outputs/stats_py.csv", index=False)

fig, (ax, axt) = plt.subplots(2, 1, sharex=True, figsize=(6, 5), gridspec_kw={"height_ratios": [3.4, 1]},
                              layout="constrained")
for g, kmf in fits.items():
    sf = kmf.survival_function_
    ax.step(sf.index, sf.iloc[:, 0], where="post", color=cols[g], lw=1.8, label=g)
    ax.plot(*cens[g], linestyle="none", marker="+", ms=5, mew=1.0, color=cols[g])
ax.text(15, 0.05, ptxt, ha="left", va="center")
ax.set_xlim(-52.5, 1102.5)  # 与 R 版一致:0~1050 两侧各留 5%
ax.set_ylim(-0.05, 1.05)   # 上下留白,与 R 版一致
ax.set_xticks(tick_times)
ax.set_yticks(np.arange(0, 1.01, 0.25))
ax.set_ylabel("Overall survival probability")
ax.legend(loc="upper right", frameon=False)

ypos = {"Male": 1, "Female": 0}
for g in groups.values():
    for t, n in zip(tick_times, risk[g]):
        axt.text(t, ypos[g], str(n), color=cols[g], ha="center", va="center")
axt.set_ylim(-0.6, 1.6)
axt.set_yticks([1, 0], ["Male", "Female"])
axt.set_xlabel("Time (days)")
axt.set_title("Number at risk", loc="left", fontsize=10)
for s in ("top", "right", "left"):
    axt.spines[s].set_visible(False)
axt.tick_params(axis="y", which="both", left=False, right=False)
axt.tick_params(axis="x", top=False)
for x in (ax, axt):
    x.minorticks_off()
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 比较两个或多个组别的“事件发生前时间”(如总生存、无进展生存),且存在删失数据
- 在生存曲线下方展示风险人数,让读者判断曲线后段估计是否还有足够的样本支撑
- 为后续 Cox 回归提供直观的组间对比
常见误用
- 曲线后段风险人数很少,估计的不确定性大,台阶式的大幅跳动不应过度解读
- log-rank 检验只回答“两条曲线是否有差异”,不给出效应大小;效应大小应报告风险比(HR)及其置信区间
- log-rank 检验在比例风险假设下效能最高;若曲线交叉,检验结果可能失真
- 本例为未调整的组间比较,性别与预后之间可能存在其他混杂因素;删失点(+)假定删失与预后无关
数据与下载
数据:R 包 survival 内置数据集 lung(晚期肺癌患者生存数据)(R 包 survival 随 CRAN 分发(LGPL-2 | LGPL-3))。228 例晚期肺癌患者的生存时间(time,天)、状态(status:1 = 删失,2 = 死亡,代码中转换为事件 = 1/0)与性别(sex:1 = 男,2 = 女)。 曲线上的“+”标记删失时间;风险人数为各时间点仍在随访中且尚未发生事件的人数(观察时间 ≥ 该时间点)。
下载包 sha256:f24d1e93ff051b6393957a07d141acab21a5b0a6c9c0a2e238131254cafd91cd