直方图 + 密度曲线(分组叠加)
GAL-0004
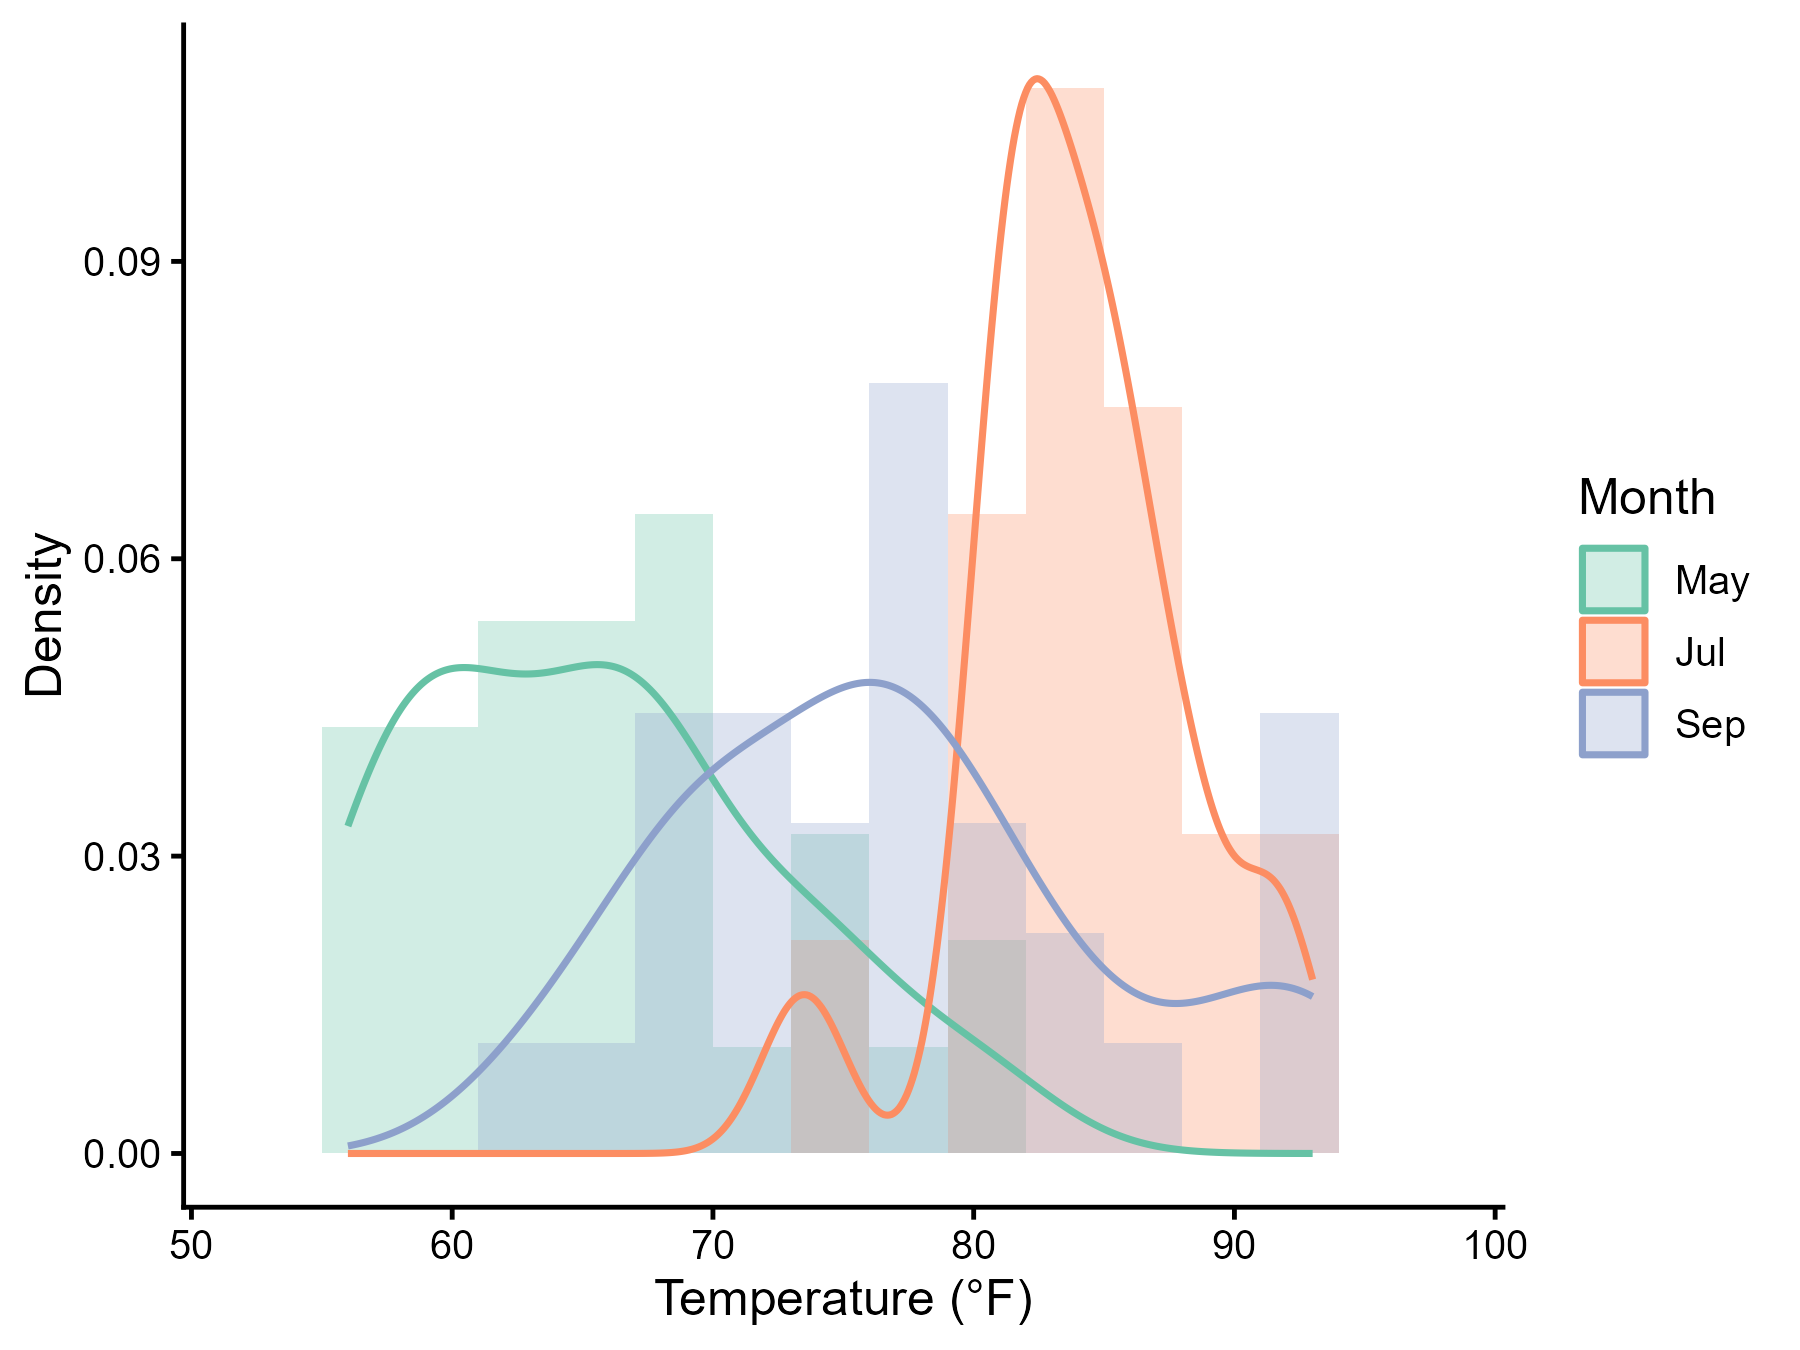
用半透明直方图展示各组数据在各区间的密度(相对频率 ÷ 组距,三组面积都为 1,便于比较不同样本量的组),再叠加核密度曲线给出平滑的分布轮廓。适合在同一坐标系里比较几个组的分布位置与离散程度。
图与代码
code/R/main.R
suppressPackageStartupMessages(library(ggplot2))

d <- read.csv("data/airquality.csv", encoding = "UTF-8")
# 只取 5、7、9 月三组,避免五组叠加过于拥挤
d <- d[d$Month %in% c(5, 7, 9), ]
d$Month <- factor(d$Month, levels = c(5, 7, 9), labels = c("May", "Jul", "Sep"))

p <- ggplot(d, aes(x = Temp, fill = Month, colour = Month)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 3, boundary = 55, closed = "left",
                 position = "identity", alpha = 0.3, colour = NA) +
  geom_density(fill = NA, linewidth = 0.8) +
  scale_fill_manual(values = c(May = "#66C2A5", Jul = "#FC8D62", Sep = "#8DA0CB")) +
  scale_colour_manual(values = c(May = "#66C2A5", Jul = "#FC8D62", Sep = "#8DA0CB")) +
  coord_cartesian(xlim = c(52, 98)) +
  labs(x = "Temperature (°F)", y = "Density", fill = "Month", colour = "Month") +
  theme_classic(base_size = 12)

ggsave("outputs/figure_r.png", p, width = 6, height = 4.5, dpi = 300, bg = "white")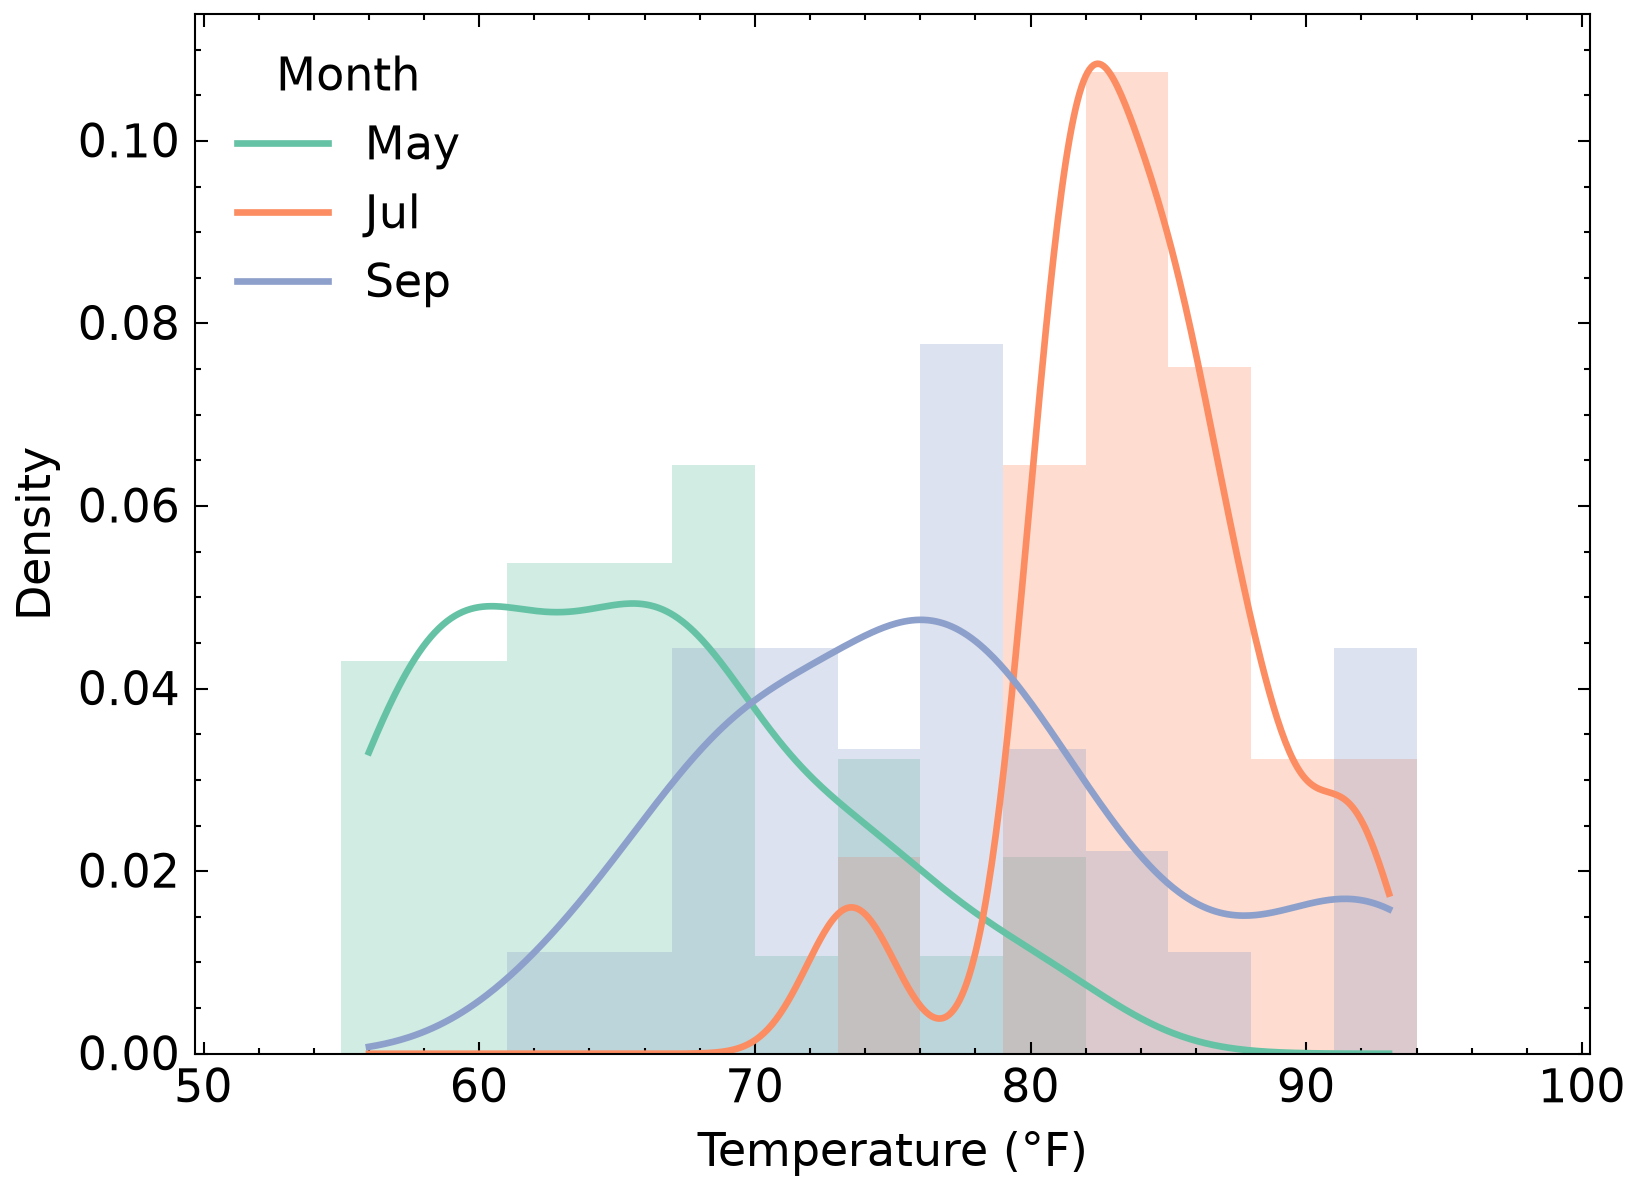
code/py/main.py
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scienceplots  # noqa: F401
from scipy.stats import gaussian_kde

plt.style.use(["science", "no-latex"])
plt.rcParams.update({"font.family": "sans-serif", "font.size": 11})  # 与 R 版(theme_classic 无衬线)统一

d = pd.read_csv("data/airquality.csv")
# 只取 5、7、9 月三组,避免五组叠加过于拥挤(与 R 版一致)
months = [5, 7, 9]
names = ["May", "Jul", "Sep"]
colors = ["#66C2A5", "#FC8D62", "#8DA0CB"]
edges = np.arange(55, 101, 3)  # 与 R 版相同:binwidth = 3;末端到 100,数据都在最后一个边界之内
d = d[d["Month"].isin(months)]
grid = np.linspace(d["Temp"].min(), d["Temp"].max(), 512)  # ggplot2 的密度曲线在全部数据范围上计算


def bw_nrd0(x):
    # 与 R 的 bw.nrd0 相同的带宽规则(ggplot2 默认)
    q75, q25 = np.percentile(x, [75, 25])
    return 0.9 * min(np.std(x, ddof=1), (q75 - q25) / 1.34) * len(x) ** -0.2


fig, ax = plt.subplots(figsize=(6, 4.5))
for m, nm, col in zip(months, names, colors):
    x = d.loc[d["Month"] == m, "Temp"].to_numpy()
    h, _ = np.histogram(x, bins=edges, density=True)
    ax.bar(edges[:-1], h, width=3, align="edge", color=col, alpha=0.3, linewidth=0)
    dens = gaussian_kde(x, bw_method=bw_nrd0(x) / np.std(x, ddof=1))(grid)
    ax.plot(grid, dens, color=col, lw=1.6, label=nm)

ax.set_xlabel("Temperature (°F)")
ax.set_ylabel("Density")
ax.legend(title="Month", loc="upper left", frameon=False)
ax.set_xlim(52 - 2.3, 98 + 2.3)  # 与 R 的 coord_cartesian 默认外扩 5% 一致
fig.savefig("outputs/figure_py.png", dpi=300, facecolor="white")
什么时候用
- 比较少数几个组(通常不超过 3~5 组)的分布位置与离散程度
- 样本量较大,希望看分布形状而非逐点
- 需要把直方图和平滑密度曲线放在一起互相印证
常见误用
- 直方图的形状取决于分箱宽度和起点,换一种分箱可能改变印象;应说明所用分箱规则
- 密度曲线取决于带宽,曲线是估计而不是数据本身;样本少时曲线的小起伏多为噪声
- 本例每组各自归一化为密度(面积为 1),纵轴高度不反映各组样本量差异
- 组数多时叠加会遮挡,难以阅读(本例因此只取三个月份);此时可改用分面或山脊图
数据与下载
数据:R 内置数据集 airquality(datasets 包)(R 内置数据集(随 R 分发,GPL-2 | GPL-3))。1973 年 5~9 月纽约的每日最高气温(Temp,单位华氏度)及月份(Month)。本例使用 Temp 与 Month 两列,去除含缺失值的行(这两列无缺失,共 153 天),图中只展示 5、7、9 月三组以免叠加拥挤。
下载包 sha256:124a85b8b6a7b5f4667e0ca8e6ddeba66ca92b0240ab6c69f30a1adcddfacb01