环形 GO 富集图(airway / GSE52778)
FIG-0003
方法/版式参考:Huang K, Liu H-Z, Liu Y, 等. Hybrid exosomal nanomotors convert pathological ROS into transport-driving cues to enhance cartilage accumulation in osteoarthritis. Nat Commun 2026;17:10310. DOI: 10.1038/s41467-026-76949-8 DOI
这张图在讲什么
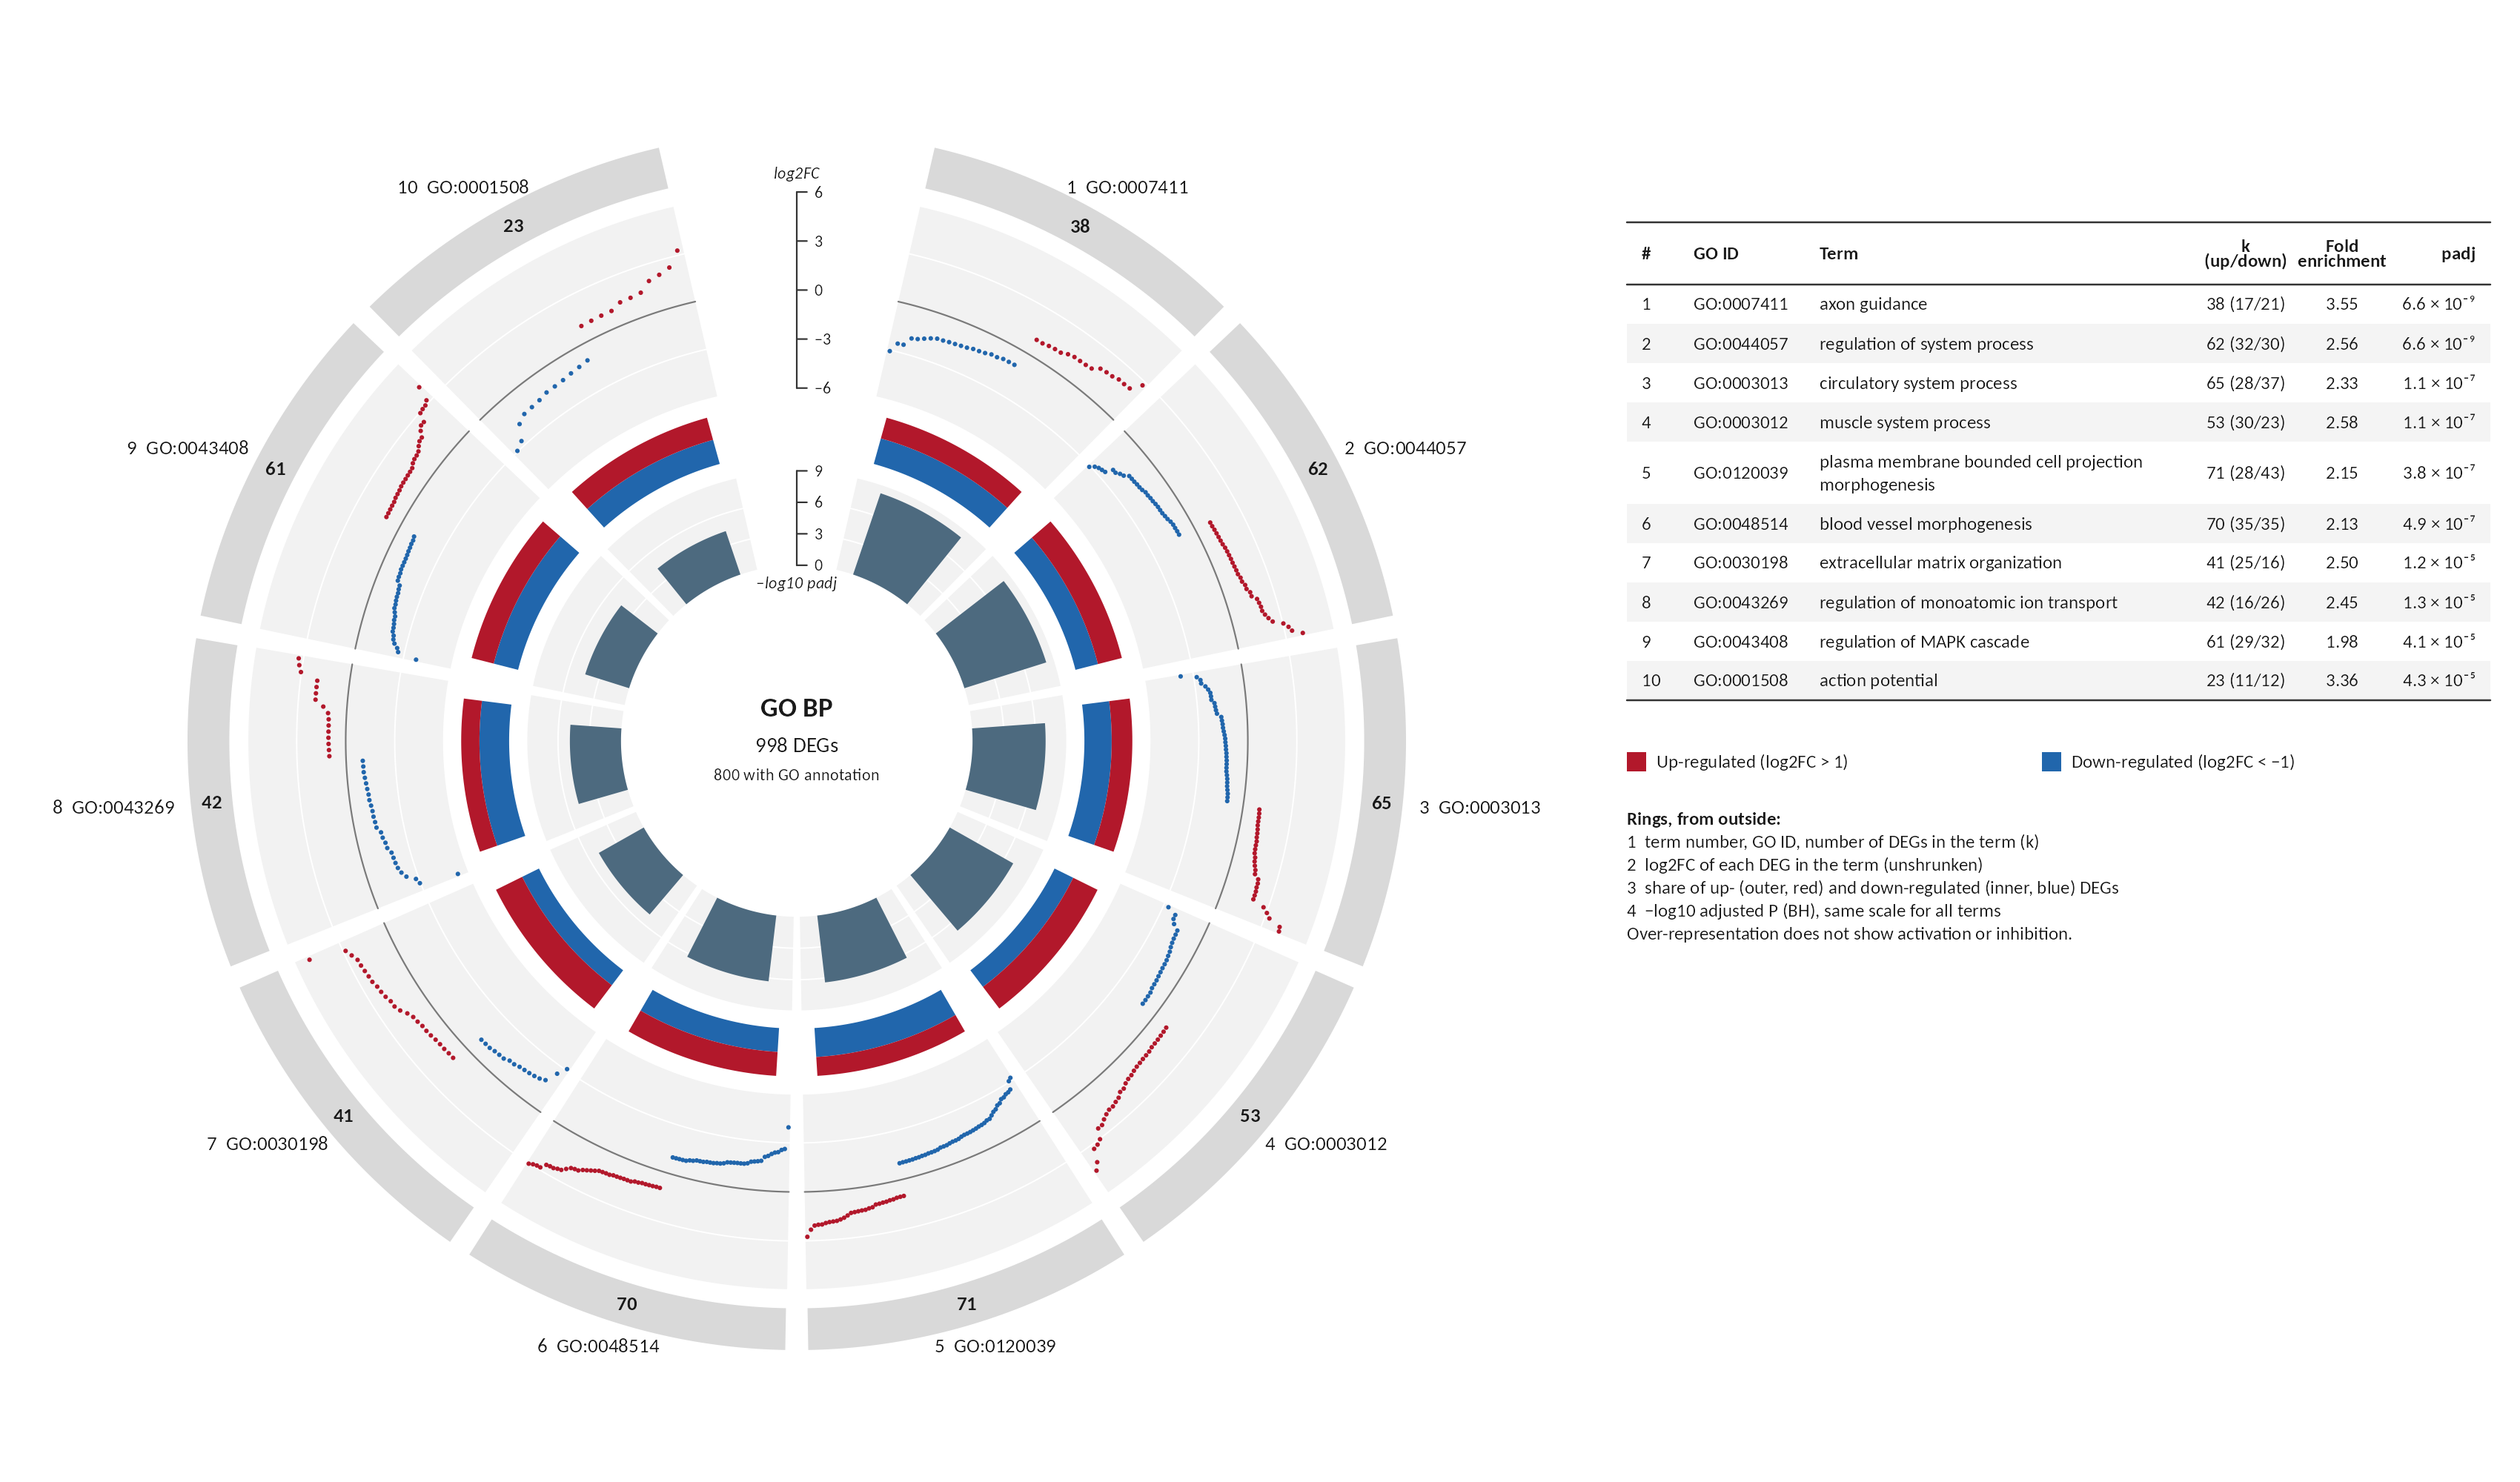
用公开的 airway RNA-seq 计数数据,比较地塞米松处理与未处理的人气道平滑肌细胞:先找差异表达基因,再看这些基因是否在某些 GO 生物过程(BP)条目中出现得比随机预期更多。
这是 L2 方法复现:用公开数据演示 DESeq2、GO 富集与环形图的完整流程,不复现参考论文的实验结果,也不复现 airway 数据原论文采用的 Cuffdiff 分析。本图独立绘制为 GOCircle 式多圈图,并非“基因—条目”弦图或连接网络。
怎么读这张图
沿着同一个 GO 条目的扇区,从外向内读:
- 条目标识与基因数:对应右侧图例中的 GO 编号、名称及该条目的差异基因数。
- log2 倍数变化散点:每个点代表该条目中的一个差异基因;正值表示处理组相对未处理组上调,负值表示下调。点在扇区内等距排列,不是染色体位置;同一个基因可能属于多个条目。
- 上调与下调比例:红色为上调、蓝色为下调,比例针对该条目内的差异基因。
- 显著性柱:高度为
−log10(padj),柱越高校正后的 p 值越小。右侧图例另列富集倍数;柱高不是富集倍数,也不是效应大小。
富集不等于通路激活。 本例把上调、下调基因合并做过度代表分析(ORA);方向信息来自基因的表达变化,不能从一个富集 p 值推断整个生物过程被激活或抑制。
数据与本例结果
输入为 data/counts.csv 中的原始整数计数和 data/samples.csv 中的样本信息。每株细胞系都包含处理与未处理样本,在模型中纳入细胞系以保留配对结构。
以下结果来自随包数值账本,不把原论文与本例的分析口径混在一起。
| 项目 | 本例结果 |
|---|---|
| 样本与细胞系 | 8 个样本,4 株细胞系 |
| 差异表达基因 | 998 个,其中上调 519 个、下调 479 个 |
| 映射后的差异 Entrez 基因 | 911 个 |
| GO 分析实际计入的差异基因 | 800 个 |
| GO 分析实际计入的背景基因 | 12032 个 |
| 参与富集检验的条目 | 4477 个 |
| 显著条目与去冗余后条目 | 571 个、217 个 |
| 环形图展示条目 | 10 个 |
“差异基因数”与“富集分析实际计入的基因数”不同:从 Ensembl 映射到 Entrez 时会丢弃或合并一部分编号,GO 分析又只计入具有相应注释的基因。计算富集倍数时,分子与背景必须使用同一口径,不能直接把差异表达基因总数代入。
分析流程与关键设置
差异分析。 DESeq2 使用 design = ~ cell + dex,以 untrt 为参照,比较处理组与未处理组;仅预先删除全部样本计数均为零的基因,采用 Wald 检验、默认独立过滤与 Cook 离群值处理。差异基因预先定义为 BH 校正后的 padj < 0.05 且 |log2FC| > 1;图中 log2FC 是未收缩估计值,没有使用 lfcShrink。
编号映射与背景。 先取 padj 非缺失的检测基因作为 Ensembl 层背景,再用 org.Hs.eg.db 映射到 Entrez。映射不到的编号与一对多 Entrez 的 Ensembl 编号丢弃;多个 Ensembl 对应同一个 Entrez 时合并,差异基因的方向及 log2FC 取其中 padj 最小者。随后由 GO 生物过程注释确定实际计入分析的背景与差异基因集合,不使用全基因组作背景。
富集与展示。 clusterProfiler::enrichGO() 使用 BP 本体、Entrez 编号和 BH 校正,基因集大小限于 10 至 500。显著条目采用 p.adjust ≤ 0.05;simplify() 以 Wang 语义相似度阈值 0.7 去冗余,保留校正 p 值较小的代表条目。去冗余不重新计算 p 值;按 p.adjust 升序、原始 p 值升序、基因数降序、GO 编号升序依次排序,展示前 10 个。
相关实现集中在 code/R/pipeline.R 的 fit_deseq()、map_ids()、run_enrich();code/R/main.R 负责数值账本、图注和出图。
下载后怎么运行
解压下载包,进入含有 run.R、code/、data/ 和 outputs/ 的 FIG-0003 目录,在 R 中把它设为工作目录,再运行:
source("run.R")运行前需安装与 renv.lock、env/sessionInfo.txt 相符的 R 和依赖包。分析主要依赖 DESeq2、clusterProfiler、AnnotationDbi、org.Hs.eg.db、GO.db,作图依赖 circlize;随包辅助代码还使用 jsonlite、systemfonts、ragg、svglite。下载包已经包含导出的计数和样本表,运行时不需要重新下载 GEO 数据或加载 airway 数据包。
run.R 设置随包辅助代码与 Carlito 字体的路径,再运行规范实现。主要结果写入 outputs/figure.png、outputs/figure.svg、outputs/numbers.json。阅读代码时可以沿“读输入 → 差异分析 → 编号映射 → 富集 → 出图”的顺序查找函数;不要只换作图函数,却保留不适合自己数据的设计公式或背景集。
运行验证状态: 本下载包已在本机记录的 R 依赖环境中复跑,重新生成的 PNG、SVG 和数值账本与随包冻结产出逐字节一致。
局限与常见误读
- 本例来自体外细胞系,不能直接推断患者疗效;样本结构、处理条件和设计公式也不能原样套到任意临床数据。
- GO 条目存在重叠和层级关系,去冗余只是减少重复展示;“前列条目”不是全部显著结果,排名也不等于生物学重要性。
- GO 注释版本、编号映射策略和背景集都会影响结果。升级包或注释库后出现差异,应先核对这些条件,而不是调整阈值追求相同的基因数。
- 独立过滤后的
padj = NA不表示 p 值为零;未收缩 log2FC 在低计数基因上可能不稳定。
数据出处与分项许可
数据来源。 airway 的计数数据来自 GEO GSE52778。请引用 Himes BE 等,PLoS One(2014),DOI: 10.1371/journal.pone.0099625,以及 airway 数据包。原文采用 CC BY;airway 包标注 LGPL。包许可、论文许可与数据权利分别记录,不能简单把“GEO 公开”理解为没有任何权利限制:NCBI 的免责声明不排除提交者可能主张的知识产权。
注释署名。 Gene Ontology 数据采用 CC BY 4.0,本例 GO 数据日期为 2025-07-22,通过 org.Hs.eg.db 与 GO.db 取得,两包记录的 GO 日期一致;包版本见 env/sessionInfo.txt。其中 org.Hs.eg.db 包许可为 Artistic-2.0。
文献参考与版式。 本案例据 Huang K 等的 Nature Communications 论文 Figure 9C 图注参考 GO 富集的展示思路;其原图图像未取得。本图使用 airway 数据与 circlize 独立绘制 GOCircle 式多圈图,不使用该论文的原始数据或图像,不宣称与其 Figure 9C 版式一致。
本站代码采用 MIT 许可,说明文字与自制图形采用 CC BY-NC 4.0;Carlito 字体采用 SIL OFL。第三方数据与资源仍按其各自条款使用,详细记录见下载包的 LICENSE、CITATION 与 provenance/出处与许可补充记录.md。冻结的历史许可记录仍保留当时的日期占位,补充记录列明了后续核对的 GO 数据来源日期和尚未确认的上游权利。
本资源仅用于方法学教学,不构成医疗建议。
代码
规范实现
code/R/main.R
# FIG-0003 规范实现:airway(GEO GSE52778)DESeq2 + GO 富集(BP)+ GOCircle 式环形图(L2)
# 设计见 notes/design.md;分析流程在 pipeline.R;本文件负责账本、出图(circlize 基础图形)、几何、图注。
# 只读 data/,只写 outputs/;数字全部由代码写入账本。运行:python -m tools.figkit run FIG-0003
#
# 画布 3400 x 2000 像素(res = 150)。左侧环形图(circlize 的正方形绘图区,边长 S 像素),右侧表格式图例。
# 几何信息(geometry.json)一律以画布像素记录(左上角为原点,y 向下)。
# 分层:每一层都在透明画布上完整重建 circlize 坐标系,只画本层元素;各层叠加 = 整图。

source(file.path(Sys.getenv("FIGKIT_LIB"), "figkit.R"))
source(file.path(fk_asset(), "code", "R", "pipeline.R"))
suppressPackageStartupMessages(library(circlize))
FONT <- fk_fonts()                      # FK-Carlito
MINUS <- "−"; TIMES <- "×"

# ---- 版面常量(版面设计,不是数据) ----
W <- 3400; H <- 2000; RES <- 150
CANVAS <- c(W, H)
CX <- 1075; CY <- 1000; S <- 1960       # 环形图正方形绘图区的中心与边长(像素);circlize 画布 [-1,1]^2 对应此区域
BIG <- 26; GAP <- 2                     # 12 点方向的大间隙(放坐标轴)与相邻扇区间隙,单位:度
R_OUT <- 0.84                           # 最外圈外缘半径(占绘图区半边长的比例)
TRACK_H <- c(sectors = 0.060, lfc = 0.270, ratio = 0.066, score = 0.130)   # 四圈的径向厚度
TRACK_MARGIN <- 0.012
E <- 1 / (R_OUT + TRACK_MARGIN)          # circlize 画布半边长(circlize 单位):使上面各量都按“绘图区半边长的比例”给出
COL_UP <- "#B2182B"; COL_DOWN <- "#2166AC"            # ColorBrewer RdBu(11 类)的第 2、第 10 色
COL_BAND <- "#D9D9D9"; COL_SCORE <- "#4D6A7F"; COL_BG <- "#F2F2F2"
COL_TXT <- "#1A1A1A"; COL_AXIS <- "#333333"; COL_STRIPE <- "#F4F4F4"
pt <- function(p) p / 12                # 字号(pt)-> cex(基础字号 12 pt)
LAYERS <- c("sectors", "lfc", "ratio", "score", "labels")

# ---- 数据与分析 ----
P <- run_pipeline()
fit <- P$fit; mp <- P$map; en <- P$enrich; gov <- P$go
res <- fit$res; shown <- en$shown
NT <- nrow(shown)
stopifnot(NT == N_TOP)                  # 不足 10 条时须回报 C,不放宽阈值凑数(design 3.5)

# 条目内 DEG 表(log2FC 取 map_ids 合并后的值)
deg <- mp$deg
pts <- do.call(rbind, lapply(seq_len(NT), function(r) {
  ent <- en$ents[[r]]; sy <- en$syms[[r]]
  d <- deg[match(ent, deg$entrez), ]
  data.frame(rank = r, entrez = ent, symbol = sy, gene_id = d$gene_id, log2FC = d$log2FoldChange,
             padj = d$padj, dir = d$dir, stringsAsFactors = FALSE)
}))
stopifnot(!anyNA(pts$log2FC))
pts <- pts[order(pts$rank, pts$log2FC, pts$entrez), ]          # 扇区内按 log2FC 升序(并列按 Entrez),不加抖动
pts$idx <- ave(pts$log2FC, pts$rank, FUN = seq_along)
pts$x <- (pts$idx - 0.5) / ave(pts$log2FC, pts$rank, FUN = length)   # 扇区内等距排列,x ∈ (0,1)
rownames(pts) <- NULL

# 刻度(由数据定死刻度范围)
LFC_L <- ceiling(max(abs(pts$log2FC)))
LFC_TICKS <- if (LFC_L %% 2 == 0) seq(-LFC_L, LFC_L, by = LFC_L / 2) else c(-LFC_L, 0, LFC_L)
nlp <- -log10(shown$p.adjust)
SC_STEP <- c(1, 2, 3, 5, 10)[which(ceiling(max(nlp) / c(1, 2, 3, 5, 10)) <= 4)[1]]
SC_TOP <- SC_STEP * ceiling(max(nlp) / SC_STEP)
SC_TICKS <- seq(0, SC_TOP, by = SC_STEP)

# ---- 显示格式(design 5.1) ----
SUP <- c("-" = "⁻", "0" = "⁰", "1" = "¹", "2" = "²", "3" = "³", "4" = "⁴",
         "5" = "⁵", "6" = "⁶", "7" = "⁷", "8" = "⁸", "9" = "⁹")
fmt_int <- function(x) as.character(as.integer(round(x)))
fmt_signed_int <- function(x) sub("^-", MINUS, as.character(as.integer(round(x))))
fmt_2 <- function(x) sub("^-", MINUS, formatC(x, format = "f", digits = 2))
fmt_p <- function(p) {
  if (p >= 0.001) return(formatC(signif(p, 3), format = "fg", digits = 3, flag = "#"))   # 3 位有效数字的普通小数
  s <- sprintf("%.1e", p)                                                                  # 科学计数法 2 位有效数字
  ex <- as.character(as.integer(sub(".*e", "", s)))
  paste0(sub("e.*", "", s), " ", TIMES, " 10", paste0(SUP[strsplit(ex, "")[[1]]], collapse = ""))
}
fmt_g <- function(x) format(x, scientific = FALSE, trim = TRUE)    # 设计常量:0.05、0.7、500

# ---- 数值账本 ----
LOC_FIT <- "code/R/pipeline.R: fit_deseq()"; LOC_MAP <- "code/R/pipeline.R: map_ids()"
LOC_EN <- "code/R/pipeline.R: run_enrich()"; LOC_MAIN <- "code/R/main.R: 账本"
cnt <- function(id, v, label, group, loc, unit = NULL) fk_num(id, v, fmt_int(v), label = label, group = group, unit = unit,
                                                              source_type = "computed", locator = loc)
cnt("n_samples", ncol(P$inp$counts), "样本数", "sample", LOC_FIT, "个")
cnt("n_cell_lines", length(unique(P$inp$samples$cell)), "细胞系数", "sample", LOC_FIT, "株")
cnt("n_samples_trt", sum(P$inp$samples$dex == "trt"), "地塞米松处理组样本数", "sample", LOC_FIT, "个")
cnt("n_samples_untrt", sum(P$inp$samples$dex == "untrt"), "未处理组样本数", "sample", LOC_FIT, "个")
cnt("n_genes_input", fit$n_input, "计数矩阵基因数(行数)", "sample", LOC_FIT, "个基因")
cnt("n_genes_allzero", fit$n_allzero, "8 个样本计数全为 0、预过滤删去的基因数", "sample", LOC_FIT, "个基因")
cnt("n_genes_tested", fit$n_tested, "进入 DESeq2 的基因数", "sample", LOC_FIT, "个基因")
cnt("n_genes_outlier", fit$n_outlier, "因 Cook 离群值 pvalue 为 NA 的基因数", "sample", LOC_FIT, "个基因")
cnt("n_genes_indepfilt", fit$n_indepfilt, "被独立过滤(padj 为 NA、pvalue 非 NA)的基因数", "sample", LOC_FIT, "个基因")
fk_num("deseq_filter_threshold", fit$filter_threshold, fmt_2(fit$filter_threshold),
       label = "独立过滤的平均标准化计数阈值", group = "sample", unit = "计数", source_type = "computed", locator = LOC_FIT)

n_deg <- sum(res$is_deg); n_up <- sum(res$dir == "up", na.rm = TRUE); n_down <- sum(res$dir == "down", na.rm = TRUE)
stopifnot(n_up + n_down == n_deg)
cnt("n_universe_ensembl", mp$n_universe_ensembl, "padj 非 NA 的基因数(Ensembl 层背景集)", "deg", LOC_MAIN, "个基因")
cnt("n_deg", n_deg, "差异基因数(Ensembl 层)", "deg", LOC_MAIN, "个基因")
cnt("n_deg_up", n_up, "上调差异基因数", "deg", LOC_MAIN, "个基因")
cnt("n_deg_down", n_down, "下调差异基因数", "deg", LOC_MAIN, "个基因")
cnt("n_padj_sig", sum(res$padj < PADJ_CUT, na.rm = TRUE), "仅 padj < 0.05(不论 log2FC)的基因数", "deg", LOC_MAIN, "个基因")

cnt("n_map_unmapped", mp$n_unmapped, "背景集中映射不到 Entrez 的 Ensembl 数", "idmap", LOC_MAP, "个基因")
cnt("n_map_multi_entrez", mp$n_multi, "对应多个 Entrez 而整体丢弃的 Ensembl 数", "idmap", LOC_MAP, "个基因")
cnt("n_map_collapsed_entrez", mp$n_collapsed, "多个 Ensembl 合并成的 Entrez 数", "idmap", LOC_MAP, "个基因")
cnt("n_map_collapse_conflict", mp$n_conflict, "合并时方向冲突的差异 Entrez 数", "idmap", LOC_MAP, "个基因")
cnt("n_universe_entrez", length(mp$universe), "映射后的背景集 Entrez 数", "idmap", LOC_MAP, "个基因")
cnt("n_deg_entrez", nrow(deg), "映射后的差异基因 Entrez 数", "idmap", LOC_MAP, "个基因")
cnt("n_deg_up_entrez", sum(deg$dir == "up"), "映射后上调差异基因 Entrez 数", "idmap", LOC_MAP, "个基因")
cnt("n_deg_down_entrez", sum(deg$dir == "down"), "映射后下调差异基因 Entrez 数", "idmap", LOC_MAP, "个基因")
stopifnot(sum(res$is_deg) >= nrow(deg), all(deg$entrez %in% mp$universe))

full <- en$full
gr_all <- parse_ratio(full$GeneRatio); br_all <- parse_ratio(full$BgRatio)
stopifnot(length(unique(gr_all$b)) == 1, length(unique(br_all$b)) == 1)     # 所有条目 n、N 相同
GO_n <- gr_all$b[1]; GO_N <- br_all$b[1]
cnt("go_N", GO_N, "clusterProfiler 实际计入的背景基因数(BgRatio 分母)", "go", LOC_EN, "个基因")
cnt("go_n", GO_n, "clusterProfiler 实际计入的差异基因数(GeneRatio 分母)", "go", LOC_EN, "个基因")
cnt("n_go_tested", en$n_tested, "enrichGO 检验的 GO 条目数(BH 校正的检验次数)", "go", LOC_EN, "个条目")
cnt("n_go_sig", en$n_sig, "p.adjust ≤ 0.05 的条目数(去冗余前)", "go", LOC_EN, "个条目")
cnt("n_go_simplified", en$n_simplified, "simplify 去冗余后的条目数", "go", LOC_EN, "个条目")
cnt("n_go_shown", NT, "展示的条目数", "go", LOC_EN, "个条目")

# GO 数据日期(字符串不进账本,按总监决定 5:日期拆成年、月、日三个数字条目,完整日期写进 figure.yaml)
parse_date <- function(s) as.integer(strsplit(s, "-", fixed = TRUE)[[1]])
for (nm in c("godb", "orgdb")) {
  dt <- parse_date(gov[[paste0(nm, "_date")]]); stopifnot(length(dt) == 3, !anyNA(dt))
  src <- if (nm == "godb") "GO.db::GO_dbInfo() 的 GOSOURCEDATE" else "org.Hs.eg.db::org.Hs.eg_dbInfo() 的 GOSOURCEDATE"
  fk_num(paste0("go_date_", nm, "_y"), dt[1], sprintf("%04d", dt[1]), label = paste0(src, "(年)"), group = "godate",
         source_type = "computed", locator = "code/R/pipeline.R: go_versions()")
  fk_num(paste0("go_date_", nm, "_m"), dt[2], sprintf("%02d", dt[2]), label = paste0(src, "(月)"), group = "godate",
         source_type = "computed", locator = "code/R/pipeline.R: go_versions()")
  fk_num(paste0("go_date_", nm, "_d"), dt[3], sprintf("%02d", dt[3]), label = paste0(src, "(日)"), group = "godate",
         source_type = "computed", locator = "code/R/pipeline.R: go_versions()")
}
bv <- unlist(packageVersion("org.Hs.eg.db")); bioc_rel <- as.numeric(sprintf("%d.%d", bv[1], bv[2]))
fk_num("bioc_release", bioc_rel, formatC(bioc_rel, format = "f", digits = 2),
       label = sprintf("org.Hs.eg.db / GO.db 的 Bioconductor 发布号(包版本 %s / %s)", gov$orgdb_ver, gov$godb_ver),
       group = "godate", source_type = "computed", locator = "code/R/pipeline.R: go_versions()")
fk_num("license_ccby_ver", 4, "4.0", label = "Gene Ontology 许可 CC BY 4.0 的版本号", group = "caption",
       source_type = "original", locator = "provenance/license.md(GO CC BY 4.0)")
fk_num("himes_year", 2014, "2014", label = "Himes 等 PLoS One 发表年份", group = "caption", source_type = "original",
       locator = "figure.yaml data.citation(Himes 等 PLoS One 2014;9:e99625)")

for (r in seq_len(NT)) {
  s <- shown[r, ]; g <- s$ID; nm <- s$Description; pre <- paste0("term", r, "_")
  tl <- function(what) sprintf("%s|%s", nm, what)
  cnt(paste0(pre, "rank"), r, tl("排名"), g, LOC_EN)
  cnt(paste0(pre, "k"), s$k, tl("条目内差异基因数 k"), g, LOC_EN, "个基因")
  cnt(paste0(pre, "k_up"), s$k_up, tl("其中上调数"), g, LOC_EN, "个基因")
  cnt(paste0(pre, "k_down"), s$k_down, tl("其中下调数"), g, LOC_EN, "个基因")
  cnt(paste0(pre, "M"), s$M, tl("条目在背景中的基因数 M"), g, LOC_EN, "个基因")
  fk_num(paste0(pre, "fe"), s$fe, fmt_2(s$fe), label = tl("富集倍数 (k/n)/(M/N)"), group = g,
         source_type = "computed", locator = LOC_EN)
  fk_num(paste0(pre, "p"), s$pvalue, fmt_p(s$pvalue), label = tl("超几何检验 p 值"), group = g,
         source_type = "computed", locator = LOC_EN)
  fk_num(paste0(pre, "padj"), s$p.adjust, fmt_p(s$p.adjust), label = tl("BH 校正 p 值"), group = g,
         source_type = "computed", locator = LOC_EN)
}

design <- list(design_padj_cut = c(PADJ_CUT, "差异基因与富集显著性的 padj 阈值"),
               design_lfc_cut = c(LFC_CUT, "差异基因的 |log2FC| 阈值"),
               design_min_gs = c(MIN_GS, "基因集大小下限 minGSSize"), design_max_gs = c(MAX_GS, "基因集大小上限 maxGSSize"),
               design_simplify_cut = c(SIMPLIFY_CUT, "simplify 语义相似度阈值(Wang)"),
               design_n_top = c(N_TOP, "展示条目数"))
for (id in names(design)) {
  v <- as.numeric(design[[id]][1])
  fk_num(id, v, fmt_g(v), label = design[[id]][2], group = "design", source_type = "computed",
         locator = "code/R/pipeline.R: 常量(分析前定死,design.md 1.5/3.2/3.4/3.5)")
}
fk_num("design_lfc_cut_neg", -LFC_CUT, fmt_signed_int(-LFC_CUT), label = "下调差异基因的 log2FC 阈值(−|log2FC| 阈值)",
       group = "design", source_type = "computed", locator = "code/R/pipeline.R: 常量 LFC_CUT")
lab_tick <- function(t) if (t < 0) paste0("m", -t) else as.character(t)
for (t in LFC_TICKS) fk_num(paste0("tick_lfc_", lab_tick(t)), t, fmt_signed_int(t), label = "第二圈(log2FC)刻度",
                            group = "tick", source_type = "computed", locator = "code/R/main.R: LFC_TICKS")
for (t in SC_TICKS) fk_num(paste0("tick_score_", t), t, fmt_int(t), label = "最内圈(−log10 padj)刻度",
                           group = "tick", source_type = "computed", locator = "code/R/main.R: SC_TICKS")
fk_num("orig_n_deg_himes", 316, "316", label = "Himes 等 2014 报告的差异基因数(Cuffdiff v2.0.2 转录本层面;BH 校正 p < 0.05,无倍数阈值);口径与本资产的 n_deg、n_padj_sig 都不可比,讲解时须同时说明口径;不上图",
       group = "original", source_type = "original",
       locator = "Himes 等 PLoS One 2014:摘要;图 1 图注;Results 小节 “RNA-Seq Transcriptome Profiling of GC-treated Primary Human ASM Cells”(Q2 对照全文 XML 核实,reviews/Q2.md 第 4.2 节)")

LEDGER <- .fk$ledger
dd <- function(id) { e <- LEDGER[[id]]; if (is.null(e)) stop("账本中没有:", id); e$display }

# ---- 图注(design 7.2、7.3;数字全部取账本 display) ----
go_date_txt <- function(nm) sprintf("%s-%s-%s", dd(paste0("go_date_", nm, "_y")), dd(paste0("go_date_", nm, "_m")),
                                    dd(paste0("go_date_", nm, "_d")))
same_date <- identical(go_date_txt("godb"), go_date_txt("orgdb"))
GO_REL_EN <- if (same_date) sprintf("release %s", go_date_txt("orgdb")) else
  sprintf("releases %s (org.Hs.eg.db annotations) and %s (GO.db term names and hierarchy)", go_date_txt("orgdb"), go_date_txt("godb"))
GO_REL_ZH <- if (same_date) sprintf("发布日期 %s", go_date_txt("orgdb")) else
  sprintf("org.Hs.eg.db 注释发布日期 %s、GO.db 条目名称与层级发布日期 %s", go_date_txt("orgdb"), go_date_txt("godb"))
CAPTION_EN <- paste0(
  "Gene Ontology biological processes over-represented among dexamethasone-responsive genes in human airway smooth muscle cells (airway / GEO GSE52778). ",
  sprintf("RNA-seq counts from %s primary airway smooth muscle cell lines, each untreated or treated with dexamethasone (%s samples), were analysed with DESeq2 (design ~ cell + dex; reference level: untreated). ",
          dd("n_cell_lines"), dd("n_samples")),
  sprintf("Differentially expressed genes (DEGs) were defined in advance as BH-adjusted P < %s and |log2 fold change| > %s (unshrunken estimates): %s genes, %s up- and %s down-regulated. ",
          dd("design_padj_cut"), dd("design_lfc_cut"), dd("n_deg"), dd("n_deg_up"), dd("n_deg_down")),
  sprintf("For over-representation analysis, Ensembl IDs were mapped to Entrez IDs (IDs without a match, and IDs matching several Entrez IDs, were dropped; IDs sharing one Entrez ID were merged): %s of the %s DEGs remained as Entrez genes, and %s of them with GO biological-process annotation were tested with clusterProfiler enrichGO. ",
          dd("n_deg_entrez"), dd("n_deg"), dd("go_n")),
  sprintf("The background was defined in the same way: the %s genes with a non-missing adjusted P after independent filtering gave %s Entrez genes, of which %s had GO annotation. Gene-set size %s–%s, BH correction across %s terms. ",
          dd("n_universe_ensembl"), dd("n_universe_entrez"), dd("go_N"), dd("design_min_gs"), dd("design_max_gs"), dd("n_go_tested")),
  sprintf("Of %s terms with adjusted P ≤ %s, redundant terms were removed with simplify (Wang similarity > %s) and the top %s by adjusted P are shown; simplification did not change any P value. ",
          dd("n_go_sig"), dd("design_padj_cut"), dd("design_simplify_cut"), dd("design_n_top")),
  "Rings, from outside: term number, GO ID and number of DEGs in the term; log2 fold change of each DEG in the term (unshrunken estimates); proportion of up- (red) and down-regulated (blue) DEGs; −log10 adjusted P. ",
  "Over-representation does not indicate whether a process is activated or inhibited. ",
  sprintf("GO annotations: Gene Ontology (CC BY %s), %s, via org.Hs.eg.db and GO.db (Bioconductor %s). ",
          dd("license_ccby_ver"), GO_REL_EN, dd("bioc_release")),
  sprintf("This figure applies standard methods to the public airway dataset (Himes et al., PLoS One %s); it does not reproduce the original study's analysis, and the layout follows the GOCircle style. ", dd("himes_year")),
  "Cell-line experiments; for methodological teaching only, not medical advice.")
CAPTION_ZH <- paste0(
  sprintf("本图使用公开的 airway 数据(GEO GSE52778,Himes 等 %s 年 PLoS One),运行同类方法:%s 株人气道平滑肌细胞,每株分别做地塞米松处理和不处理,共 %s 个样本。",
          dd("himes_year"), dd("n_cell_lines"), dd("n_samples")),
  "用 DESeq2 做差异分析,模型中纳入细胞系(相当于配对),以未处理为参照。",
  sprintf("差异基因的标准在分析前定好:BH 校正后的 P 小于 %s,且倍数变化的 log2 值绝对值大于 %s(未收缩的估计值),共 %s 个,其中上调 %s 个、下调 %s 个。",
          dd("design_padj_cut"), dd("design_lfc_cut"), dd("n_deg"), dd("n_deg_up"), dd("n_deg_down")),
  sprintf("再做 GO 生物过程的过表达分析:先把 Ensembl 编号映射为 Entrez 编号(映射不到的、对应多个 Entrez 的编号丢弃,共用同一个 Entrez 的合并),%s 个差异基因中有 %s 个留作 Entrez 基因,其中 %s 个有 GO 生物过程注释,用 clusterProfiler 检验。",
          dd("n_deg"), dd("n_deg_entrez"), dd("go_n")),
  sprintf("背景集按同样口径确定:独立过滤后校正 P 值不缺失的 %s 个基因,映射后为 %s 个 Entrez 基因,其中 %s 个有 GO 注释;基因集大小 %s 至 %s,BH 校正覆盖 %s 个条目。",
          dd("n_universe_ensembl"), dd("n_universe_entrez"), dd("go_N"), dd("design_min_gs"), dd("design_max_gs"), dd("n_go_tested")),
  sprintf("%s 个条目的校正 P 值不大于 %s,去冗余(Wang 相似度大于 %s)后,按校正 P 值取前 %s 个画成环形图,去冗余不改变任何 P 值:",
          dd("n_go_sig"), dd("design_padj_cut"), dd("design_simplify_cut"), dd("design_n_top")),
  "最外圈是条目编号、GO 编号和条目中的差异基因数,第二圈每个点是一个差异基因的 log2 倍数变化,第三圈是上调(红)与下调(蓝)基因的比例,最内圈柱子越高校正 P 值越小。",
  "富集只说明这些过程里的差异基因“比随机预期多”,不说明过程被激活还是被抑制;细胞系实验结果也不能直接推到病人身上。",
  sprintf("GO 注释来自 Gene Ontology(CC BY %s),%s,经 org.Hs.eg.db 与 GO.db(Bioconductor %s)取得。",
          dd("license_ccby_ver"), GO_REL_ZH, dd("bioc_release")),
  "本图仅为方法教学,不构成医疗建议,也不是对原论文分析的复现。")

# ---- 版面:圈层与坐标 ----
SECT <- factor(seq_len(NT), levels = seq_len(NT))
.st <- new.env(); .st$started <- FALSE; .st$geom_done <- FALSE; .st$collect <- FALSE; .st$texts <- character()
# 带登记的 text():只在“单层绘制”那一遍登记文字,供数字扫描
tx <- function(x, y, labels, ...) {
  text(x, y, labels, ...)
  if (.st$collect) .st$texts <- c(.st$texts, labels)
  invisible()
}

# 当前绘图区用户坐标 -> 画布像素(解析式,用 fig、plt、usr 换算,不依赖绘图区是否正方形)
u2px <- function(x, y) {
  fg <- par("fig"); pl <- par("plt"); us <- par("usr")
  nx <- fg[1] + (pl[1] + (x - us[1]) / (us[2] - us[1]) * (pl[2] - pl[1])) * (fg[2] - fg[1])
  ny <- fg[3] + (pl[3] + (y - us[3]) / (us[4] - us[3]) * (pl[4] - pl[3])) * (fg[4] - fg[3])
  cbind(x = nx * W, y = H * (1 - ny))
}
polar2Cartesian <- function(m) { m <- matrix(m, ncol = 2); cbind(m[, 2] * cos(m[, 1] * pi / 180), m[, 2] * sin(m[, 1] * pi / 180)) }   # (theta°, rou) -> (x, y)
cxy <- function(r, ring, xv, yv) {              # 单元格数据坐标 -> 用户坐标(笛卡尔,circlize 单位)
  p <- circlize(xv, yv, sector.index = r, track.index = ring)
  polar2Cartesian(cbind(p[, 1], p[, 2]))
}
cell_xy <- function(r, ring, xf, yf) {          # 单元格内相对位置 (xf, yf ∈ [0,1]) -> 用户坐标
  xl <- get.cell.meta.data("xlim", r, ring); yl <- get.cell.meta.data("ylim", r, ring)
  cxy(r, ring, xl[1] + xf * diff(xl), yl[1] + yf * diff(yl))
}
pol_xy <- function(theta, rou) polar2Cartesian(cbind(theta, rou))     # theta:数学角(度,逆时针自 3 点)
clockdeg <- function(theta) (90 - theta) %% 360                        # 数学角 -> 自 12 点顺时针的角

pix_space <- function() {                       # 像素坐标系:x 向右、y 向下
  par(fig = c(0, 1, 0, 1), mai = c(0, 0, 0, 0), omi = c(0, 0, 0, 0), new = .st$started, xpd = NA, family = FONT, ps = 12)
  plot.new(); plot.window(xlim = c(0, W), ylim = c(H, 0), xaxs = "i", yaxs = "i")
  .st$started <- TRUE
}

# ---- 表格式图例的版面(像素) ----
TXT_PT <- 12; LH <- 31                          # 正文 12 pt,行高 31 px
TAB_X0 <- 2195; TAB_X1 <- 3360                  # 表格左右边界(右侧留 40 px 边距)
TAB_X <- c(num = 2215, id = 2285, term = 2455, k = 3030, fe = 3160, padj = 3340)   # 列锚点(k、fe 居中;padj 右对齐)
TAB_TOP <- 300; ROW_PAD <- 11
wrap_term <- function(x) strwrap(x, width = 41)  # 每行不超过 40 个字符,在空格处断
term_lines <- lapply(shown$Description, wrap_term)
stopifnot(all(unlist(lapply(term_lines, nchar)) <= 40), identical(paste(term_lines[[1]], collapse = " "), shown$Description[1]))
row_h <- pmax(lengths(term_lines), 1) * LH + 2 * ROW_PAD
HDR_H <- 2 * LH + 2 * ROW_PAD
row_y0 <- TAB_TOP + HDR_H + c(0, cumsum(row_h))[seq_len(NT)]
row_y1 <- row_y0 + row_h
TAB_BOTTOM <- row_y1[NT]
KEY_Y <- TAB_BOTTOM + 70

# ---- 几何(画布像素) ----
# 须在圈层坐标系建立之后调用(sectors 层那一遍);图例行是版面常量,同时登记
record_geometry <- function(th, rad) {
  ppu <- S / (2 * E)                                             # circlize 单位 -> 像素
  to_px <- function(xy) u2px(xy[1], xy[2])
  rk <- function(ring) rad(ring) * ppu
  for (r in seq_len(NT)) {
    a0 <- clockdeg(th[[r]][1]); a1 <- clockdeg(th[[r]][2])        # 自 12 点顺时针(度),a0 < a1
    stopifnot(a0 < a1)
    rr <- rk(1)
    c1 <- to_px(cell_xy(r, 1, 0.5, 0.5))
    fk_geom(paste0("sector_", r), "sector", "sectors", cx = c1[1], cy = c1[2], center_x = CX, center_y = CY,
            angle_start = a0, angle_end = a1, r_in = rr[1], r_out = rr[2], num = paste0("term", r, "_k"))
    c2 <- to_px(cell_xy(r, 2, 0.5, 0.5)); c3 <- to_px(cell_xy(r, 3, 0.5, 0.5))
    fk_geom(paste0("ring2_", r), "point", "lfc", x = c2[1], y = c2[2], r_in = rk(2)[1], r_out = rk(2)[2], num = paste0("term", r, "_k"))
    fk_geom(paste0("ring3_", r), "point", "ratio", x = c3[1], y = c3[2], r_in = rk(3)[1], r_out = rk(3)[2], num = paste0("term", r, "_k"))
    fd <- shown$k_down[r] / shown$k[r]
    up <- to_px(cell_xy(r, 3, 0.5, (fd + 1) / 2)); dn <- to_px(cell_xy(r, 3, 0.5, fd / 2))
    fk_geom(paste0("ratio_up_", r), "point", "ratio", x = up[1], y = up[2], num = paste0("term", r, "_k_up"))
    fk_geom(paste0("ratio_down_", r), "point", "ratio", x = dn[1], y = dn[2], num = paste0("term", r, "_k_down"))
    bar <- to_px(cxy(r, 4, 0.5, nlp[r] / 2))                       # 内圈柱的中心
    bt <- to_px(cxy(r, 4, 0.5, nlp[r]))                            # 柱顶中点
    fk_geom(paste0("score_bar_", r), "point", "score", x = bar[1], y = bar[2], top_x = bt[1], top_y = bt[2],
            r_in = rk(4)[1], r_out = rk(4)[2], num = paste0("term", r, "_padj"))
    d <- pts[pts$rank == r, ]
    gp <- u2px(cxy(r, 2, d$x, d$log2FC)[, 1], cxy(r, 2, d$x, d$log2FC)[, 2])
    for (i in seq_len(nrow(d)))
      fk_geom(sprintf("gene_t%d_%s", r, d$symbol[i]), "point", "lfc", x = gp[i, 1], y = gp[i, 2], num = paste0("term", r, "_k"))
    fk_geom(paste0("legend_row_", r), "box", "labels", x0 = TAB_X0, y0 = row_y0[r], x1 = TAB_X1, y1 = row_y1[r],
            num = paste0("term", r, "_rank"))
  }
  fk_geom("ring_center", "point", "labels", x = CX, y = CY)
  .st$geom_done <- TRUE
}

# ---- 绘图 ----
draw <- function(layers) {
  single <- length(layers) == 1
  .st$collect <- single
  .st$started <- FALSE
  act <- function(l) l %in% layers
  par(family = FONT, ps = 12, xpd = NA)

  if (any(c("sectors", "lfc", "ratio", "score") %in% layers)) {
    par(fig = c((CX - S / 2) / W, (CX + S / 2) / W, 1 - (CY + S / 2) / H, 1 - (CY - S / 2) / H),
        mai = c(0, 0, 0, 0), omi = c(0, 0, 0, 0), new = FALSE, xpd = NA, family = FONT, ps = 12, xaxs = "i", yaxs = "i")
    circos.clear()
    on.exit(circos.clear(), add = TRUE)
    circos.par(start.degree = 90 - BIG / 2, clock.wise = TRUE, gap.after = c(rep(GAP, NT - 1), BIG),
               cell.padding = c(0, 0, 0, 0), track.margin = c(TRACK_MARGIN, TRACK_MARGIN) * E,
               canvas.xlim = c(-E, E), canvas.ylim = c(-E, E))
    circos.initialize(SECT, xlim = matrix(c(0, 1), nrow = NT, ncol = 2, byrow = TRUE))
    .st$started <- TRUE
    for (ring in 1:4) {                          # 四圈的轨道在每一层里都完整建立,只在对应层里着色
      nm <- LAYERS[ring]
      ylim <- switch(nm, sectors = c(0, 1), lfc = c(-LFC_L, LFC_L), ratio = c(0, 1), score = c(0, SC_TOP))
      bg <- if (act(nm)) switch(nm, sectors = COL_BAND, lfc = COL_BG, ratio = NA, score = COL_BG) else NA
      circos.track(ylim = ylim, track.height = TRACK_H[[nm]] * E, bg.col = bg,
                   bg.border = if (act(nm) && nm == "sectors") "white" else NA, bg.lwd = 1.5)
    }
    rad <- function(ring) c(get.cell.meta.data("cell.bottom.radius", 1, ring), get.cell.meta.data("cell.top.radius", 1, ring))
    stopifnot(abs(rad(1)[2] - R_OUT * E) < 1e-6)
    th <- lapply(seq_len(NT), function(r) c(get.cell.meta.data("cell.start.degree", r, 1), get.cell.meta.data("cell.end.degree", r, 1)))
    if (single && !.st$geom_done && act("sectors")) record_geometry(th, rad)

    # 第 1 圈:扇区色带、k、外侧标签(排名编号 + GO ID)
    if (act("sectors")) {
      for (r in seq_len(NT)) {
        xy <- cell_xy(r, 1, 0.5, 0.5)
        tx(xy[1], xy[2], dd(paste0("term", r, "_k")), cex = pt(13), font = 2, col = COL_TXT)
        mid <- mean(th[[r]]); c0 <- cos(mid * pi / 180); s0 <- sin(mid * pi / 180)
        a <- pol_xy(mid, (R_OUT + 0.022) * E)
        tx(a[1], a[2], paste0(dd(paste0("term", r, "_rank")), "  ", shown$ID[r]), cex = pt(13),
           adj = c((1 - c0) / 2, (1 - s0) / 2), col = COL_TXT)
      }
    }
    # 第 2 圈:log2FC 散点(径向位置 = log2FC)、0 参考线、刻度线
    if (act("lfc")) {
      for (t in setdiff(LFC_TICKS, 0)) for (r in seq_len(NT))
        circos.lines(c(0, 1), c(t, t), sector.index = r, track.index = 2, col = "white", lwd = 1.2)
      for (r in seq_len(NT)) {
        circos.lines(c(0, 1), c(0, 0), sector.index = r, track.index = 2, col = "#7A7A7A", lwd = 1.4)
        d <- pts[pts$rank == r, ]
        circos.points(d$x, d$log2FC, sector.index = r, track.index = 2, pch = 16, cex = 0.55,
                      col = ifelse(d$dir == "up", COL_UP, COL_DOWN))
      }
    }
    # 第 3 圈:上调/下调比例(上调段在外、下调段在内,满长 = 1)
    if (act("ratio")) {
      for (r in seq_len(NT)) {
        fd <- shown$k_down[r] / shown$k[r]
        circos.rect(0.08, 0, 0.92, fd, sector.index = r, track.index = 3, col = COL_DOWN, border = NA)
        circos.rect(0.08, fd, 0.92, 1, sector.index = r, track.index = 3, col = COL_UP, border = NA)
      }
    }
    # 第 4 圈:−log10(padj) 柱,同一刻度
    if (act("score")) {
      for (t in setdiff(SC_TICKS, 0)) for (r in seq_len(NT))
        circos.lines(c(0, 1), c(t, t), sector.index = r, track.index = 4, col = "white", lwd = 1.2)
      for (r in seq_len(NT))
        circos.rect(0.18, 0, 0.82, nlp[r], sector.index = r, track.index = 4, col = COL_SCORE, border = NA)
    }
    # 12 点方向间隙里的小刻度轴
    axis_y <- function(ring, ticks, ymin, ymax, labs) {
      rb <- rad(ring)[1]; rt <- rad(ring)[2]
      yr <- function(v) rb + (v - ymin) / (ymax - ymin) * (rt - rb)
      segments(0, yr(ymin), 0, yr(ymax), col = COL_AXIS, lwd = 1.4)
      segments(0, yr(ticks), 0.014 * E, yr(ticks), col = COL_AXIS, lwd = 1.4)
      tx(0.024 * E, yr(ticks), labs, adj = c(0, 0.5), cex = pt(11), col = COL_TXT)
    }
    if (act("lfc")) {
      axis_y(2, LFC_TICKS, -LFC_L, LFC_L, fmt_signed_int(LFC_TICKS))
      tx(0, rad(2)[2] + 0.018 * E, "log2FC", adj = c(0.5, 0), cex = pt(11), font = 3, col = COL_TXT)
    }
    if (act("score")) {
      axis_y(4, SC_TICKS, 0, SC_TOP, fmt_int(SC_TICKS))
      tx(0, rad(4)[1] - 0.016 * E, paste0(MINUS, "log10 padj"), adj = c(0.5, 1), cex = pt(11), font = 3, col = COL_TXT)
    }
  }

  if (act("labels")) {
    pix_space()
    # 环中心文字
    tx(CX, CY - 45, "GO BP", cex = pt(18), font = 2, col = COL_TXT)
    tx(CX, CY + 5, paste0(dd("n_deg"), " DEGs"), cex = pt(14), col = COL_TXT)
    tx(CX, CY + 45, paste0(dd("go_n"), " with GO annotation"), cex = pt(11), col = COL_TXT)
    # 表格式图例
    cx <- function(n) TAB_X[[n]]
    for (r in seq_len(NT)) if (r %% 2 == 0) rect(TAB_X0, row_y0[r], TAB_X1, row_y1[r], col = COL_STRIPE, border = NA)
    hy <- TAB_TOP + HDR_H / 2
    hdr <- function(x, lab, adj = c(0, 0.5)) tx(x, hy, lab, adj = adj, cex = pt(TXT_PT), font = 2, col = COL_TXT)
    hdr(cx("num"), "#"); hdr(cx("id"), "GO ID"); hdr(cx("term"), "Term")
    tx(cx("k"), hy, c("k"), adj = c(0.5, -0.1), cex = pt(TXT_PT), font = 2, col = COL_TXT)
    tx(cx("k"), hy, "(up/down)", adj = c(0.5, 1.1), cex = pt(TXT_PT), font = 2, col = COL_TXT)
    tx(cx("fe"), hy, "Fold", adj = c(0.5, -0.1), cex = pt(TXT_PT), font = 2, col = COL_TXT)
    tx(cx("fe"), hy, "enrichment", adj = c(0.5, 1.1), cex = pt(TXT_PT), font = 2, col = COL_TXT)
    hdr(cx("padj"), "padj", adj = c(1, 0.5))
    segments(TAB_X0, TAB_TOP + HDR_H, TAB_X1, TAB_TOP + HDR_H, col = COL_AXIS, lwd = 1.6)
    segments(TAB_X0, TAB_TOP, TAB_X1, TAB_TOP, col = COL_AXIS, lwd = 1.6)
    segments(TAB_X0, TAB_BOTTOM, TAB_X1, TAB_BOTTOM, col = COL_AXIS, lwd = 1.6)
    for (r in seq_len(NT)) {
      ym <- (row_y0[r] + row_y1[r]) / 2
      tx(cx("num"), ym, dd(paste0("term", r, "_rank")), adj = c(0, 0.5), cex = pt(TXT_PT), col = COL_TXT)
      tx(cx("id"), ym, shown$ID[r], adj = c(0, 0.5), cex = pt(TXT_PT), col = COL_TXT)
      nl <- length(term_lines[[r]])
      tx(cx("term"), row_y0[r] + ROW_PAD + (seq_len(nl) - 0.5) * LH, term_lines[[r]], adj = c(0, 0.5), cex = pt(TXT_PT), col = COL_TXT)
      tx(cx("k"), ym, sprintf("%s (%s/%s)", dd(paste0("term", r, "_k")), dd(paste0("term", r, "_k_up")), dd(paste0("term", r, "_k_down"))),
         adj = c(0.5, 0.5), cex = pt(TXT_PT), col = COL_TXT)
      tx(cx("fe"), ym, dd(paste0("term", r, "_fe")), adj = c(0.5, 0.5), cex = pt(TXT_PT), col = COL_TXT)
      tx(cx("padj"), ym, dd(paste0("term", r, "_padj")), adj = c(1, 0.5), cex = pt(TXT_PT), col = COL_TXT)
    }
    # 颜色图例
    sw <- 26
    rect(TAB_X0, KEY_Y, TAB_X0 + sw, KEY_Y + sw, col = COL_UP, border = NA)
    tx(TAB_X0 + sw + 14, KEY_Y + sw / 2, paste0("Up-regulated (log2FC > ", dd("design_lfc_cut"), ")"), adj = c(0, 0.5), cex = pt(TXT_PT), col = COL_TXT)
    rect(TAB_X0 + 560, KEY_Y, TAB_X0 + 560 + sw, KEY_Y + sw, col = COL_DOWN, border = NA)
    tx(TAB_X0 + 560 + sw + 14, KEY_Y + sw / 2, paste0("Down-regulated (log2FC < ", dd("design_lfc_cut_neg"), ")"), adj = c(0, 0.5), cex = pt(TXT_PT), col = COL_TXT)
    # 读图说明(不含数字)
    ex <- c("Rings, from outside:",
            "1  term number, GO ID, number of DEGs in the term (k)",
            "2  log2FC of each DEG in the term (unshrunken)",
            "3  share of up- (outer, red) and down-regulated (inner, blue) DEGs",
            paste0("4  ", MINUS, "log10 adjusted P (BH), same scale for all terms"),
            "Over-representation does not show activation or inhibition.")
    ey <- KEY_Y + 90 + (seq_along(ex) - 1) * LH
    tx(TAB_X0, ey, ex, adj = c(0, 0.5), cex = pt(TXT_PT), font = c(2, rep(1, length(ex) - 1)), col = COL_TXT)
  }
  invisible()
}

# 数字扫描用的单层文字清单与图注写在 fk_render 之后;图例行版面须在几何登记前就位(上面已算好)
fk_render(draw, LAYERS, canvas = CANVAS, res = RES)
stopifnot(.st$geom_done)

# ---- 其余产出 ----
writeLines(c(CAPTION_EN), fk_out("caption_en.txt"), useBytes = TRUE)
writeLines(c(CAPTION_ZH), fk_out("caption_zh.txt"), useBytes = TRUE)
writeLines(enc2utf8(.st$texts), fk_out("figure_text.txt"), useBytes = TRUE)

wr <- function(df, f) {                  # LF、UTF-8、不写行名
  con <- file(fk_out(f), open = "wb"); on.exit(close(con))
  write.csv(df, con, row.names = FALSE, eol = "\n", fileEncoding = "UTF-8", na = "")
}
full_out <- en$full; full_out$ID <- rownames(full_out)
wr(full_out[, c("ID", "Description", "GeneRatio", "BgRatio", "pvalue", "p.adjust", "Count", "geneID")], "enrich_full.csv")
shown_out <- shown[, c("rank", "ID", "Description", "GeneRatio", "BgRatio", "k", "n", "M", "N", "k_up", "k_down", "fe",
                       "pvalue", "p.adjust", "geneEntrez", "geneSymbol")]
wr(shown_out, "enrich_shown.csv")
wr(res[res$is_deg, c("gene_id", "baseMean", "log2FoldChange", "lfcSE", "stat", "pvalue", "padj", "dir")], "deg_list.csv")
wr(pts[, c("rank", "idx", "symbol", "entrez", "gene_id", "log2FC", "padj", "dir")], "ring2_points.csv")
# 供“两次运行逐元素一致”测试使用:DESeq2 全表、DEG 列表、运行 A 全表、展示条目表
saveRDS(list(res = res, deg = res[res$is_deg, ], full = en$full, shown = en$shown), fk_out("pipeline_tables.rds"))
writeLines(c("# FIG-0003 运行日志(由 main.R 生成;无时间戳,以保证产出可复现)", .log$lines,
             "simplify 并列处理:见 notes/impl_notes.md"), fk_out("run_log.txt"), useBytes = TRUE)

fk_finish(list(canvas = CANVAS))
示例数据与下载
| 文件 | 大小 | sha256 |
|---|---|---|
| FIG-0003_v1.1.zip | 2895 KB | 36314fbde4a0e3259c1b17641f3025353176a1ef8bd431aeba6b37c7049b86f6 |
下载包内含代码、示例数据、冻结产出、README、LICENSE、CITATION 与 SHA256SUMS。
出处与如何引用
请先引用原始论文:Huang K, Liu H-Z, Liu Y, 等. Hybrid exosomal nanomotors convert pathological ROS into transport-driving cues to enhance cartilage accumulation in osteoarthritis. Nat Commun 2026;17:10310. DOI: 10.1038/s41467-026-76949-8
引用本资源:ZZY的科研图谱. FIG-0003 环形 GO 富集图(airway / GSE52778)(v1.1). 见如何引用。